
Automatiser le contrôle qualité de la langue chez Transloadit

Cet article décrit notre configuration de publication de 2015. Les noms de paquets et la configuration ci-dessous sont historiques et ne constituent pas des instructions d’installation pour la chaîne d’outils actuelle.
J’étais en train de rédiger une documentation interne expliquant comment j’avais mis en place la vérification automatisée de la langue chez Transloadit. À mi-chemin, je me suis dit que cela pourrait aussi servir au reste du monde 🌎, alors je l’ai réécrite de façon plus générique. Je vais d’abord tenter de donner une vue d’ensemble du problème, avant de descendre jusqu’aux détails concrets de sa résolution. J’espère que cela vous plaira, c’est parti !
Chez Transloadit, nous avons extrait tous les blocs de texte d’une certaine taille (documentation, articles de blog, pages statiques) vers un dépôt de contenu distinct.
Jusqu’à cette migration, nos textes étaient éparpillés entre des tables MySQL, des gabarits et des fichiers HTML. Une grande soupe de contenu, de mise en page, de code et d’emplacements. Les développeurs pouvaient tout consulter, mais sans grand plaisir. Les non-développeurs n’avaient aucune chance.
Nous avons pensé qu’il serait intéressant de voir si nous pouvions attirer des rédacteurs techniques et leur donner un accès complet à notre contenu. Nous imaginions qu’ils pourraient utiliser l’interface web de GitHub à la manière d’un wiki, afin d’améliorer nos textes sans être distraits par le code, sans le modifier par accident et sans avoir besoin de compétences poussées dans ce domaine.
Cela n’a pas encore atteint son plein potentiel, mais :
- en tant que développeurs, nous apprécions déjà de travailler sur le contenu (purement Markdown)
- regrouper tout le contenu dans un dépôt distinct ouvre la porte à d’autres possibilités intéressantes, comme le contrôle qualité automatisé, ou encore : l’intégration continue
Intégration continue
L’intégration continue est un concept habituellement associé au code. ThoughtWorks l’explique ainsi :
L’intégration continue (CI) est une pratique de développement qui exige que les développeurs intègrent leur code dans un dépôt partagé plusieurs fois par jour. Chaque intégration est ensuite vérifiée par un build automatisé, ce qui permet aux équipes de détecter les problèmes tôt.
Chez Transloadit, nous l’utilisions déjà pour l’ensemble de notre code. Mais pourrions-nous aussi l’utiliser pour notre anglais ?
Cette question était particulièrement pertinente pour nous car, si la majorité de nos clients vit aux États-Unis, Transloadit est basé à Berlin, et personne dans notre équipe actuelle n’a l’anglais pour langue maternelle.
Étant donné à quel point les fautes de langue peuvent nuire lorsque des personnes en sont encore aux premiers stades de l’évaluation d’un produit, mettre en place quelques contrôles supplémentaires est d’autant plus important pour nous.
Nous ciblons la mauvaise qualité du contenu dans trois domaines :
Écriture inconsidérée
Pour citer npm weekly :
Il y a fort à parier qu’aucun d’entre nous n’a l’intention d’exclure ou de blesser d’autres membres de la communauté, mais un langage clivant et favorisant un genre a tendance à se glisser dans ce que nous écrivons. Il est parfois très utile d’avoir un second regard pour relire, remarquer ce qui nous a échappé et nous pousser à être plus attentionnés et inclusifs. Alex aide à « repérer les écrits insensibles et inconsidérés » en identifiant le langage potentiellement offensant et en suggérant des alternatives utiles.
Pour installer alex, nous exécutons simplement npm install --save alex.
Alex n’est pas aussi intelligent qu’un humain, mais il fait de son mieux et se montre parfois un peu trop enthousiaste pour vous signaler qu’un passage pourrait être insensible.
Il peut donc y avoir occasionnellement des faux positifs, et comme nous ne voulons pas que les avertissements d’alex soient bloquants, nous utilisons
node_modules/.bin/alex || true
Ainsi, nous voyons les formulations qu’alex juge améliorables, sans pour autant rendre ces suggestions critiques.
Par exemple
74:74-74:76 warning $(he) may be insensitive, use $(they), $(it) instead
Grâce à ce projet, nous réécrivons actuellement notre documentation pour la rendre plus inclusive.
Mise en forme désordonnée
Nos fichiers texte sont au format Markdown. Nous avons choisi ce format, car il :
- est assez facile à assimiler pour les humains comme pour les ordinateurs,
- dispose d’un excellent écosystème d’outils, et
- offre une bonne séparation entre la structure d’un document et sa mise en page. Nous pouvons indiquer qu’un passage est mis en valeur, mais pas qu’il est en Comic Sans. Ces décisions reviennent aux designers.
Il existe souvent plusieurs façons d’arriver au même résultat en Markdown. Comme pour le code, il est utile de s’accorder sur une convention et d’obliger chaque contributeur à la respecter. En supprimant une partie de cette liberté artistique (inutile), on obtient un document qui paraît bien entretenu et qui invite à d’autres contributions.
Pour cela, nous utilisons mdast avec un plugin de lint :
npm install --save mdast mdast-lint
Comme nous ne voulons ni vérifier des projets externes (comme mdast lui-même), ni revérifier les artefacts générés, nous excluons quelques emplacements
printf '%s\n' '_site/' 'node_modules/' >> .mdastignore
Nous avons ensuite enregistré la convention suivante dans .mdastrc, mais elle dépend bien sûr de vos
paramètres et de vos
préférences de lint
{
  "plugins": {
    "lint": {
        "blockquote-indentation": 2,
        "emphasis-marker": "*",
        "first-heading-level": false,
        "link-title-style": "\"",
        "list-item-indent": false,
        "list-item-spacing": false,
        "no-shell-dollars": false,
        "maximum-heading-length": false,
        "maximum-line-length": false,
        "no-duplicate-headings": false,
        "no-blockquote-without-caret": false,
        "no-file-name-irregular-characters": true,
        "no-file-name-outer-dashes": false,
        "no-heading-punctuation": false,
        "no-html": false,
        "no-multiple-toplevel-headings": false,
        "ordered-list-marker-style": ".",
        "ordered-list-marker-value": "one",
        "strong-marker": "*"
    }
  },
  "settings": {
    "gfm": true,
    "yaml": true,
    "rule": "-",
    "ruleSpaces": false,
    "ruleRepetition": 70,
    "emphasis": "*",
    "listItemIndent": "1",
    "incrementListMarker": false,
    "spacedTable": false
  }
}
Puis nous lançons le lint pour la première fois
node_modules/.bin/mdast --frail .
Ce qui peut renvoyer
_posts/2015-09-15-spelling.md
246:1 warning Use spaces instead of hard-tabs no-tabs
En prime, mdast peut même tenter de corriger cela automatiquement
node_modules/.bin/mdast --output .
Nous avons été impressionnés par tout ce que mdast a pu corriger. Assurez-vous toutefois que vos fichiers sont commités dans Git avant d’exécuter cette commande. Vous voudrez examiner les modifications apportées et les annuler si nécessaire. Il faudra très probablement quelques itérations pour obtenir un bon résultat.
Fautes d’orthographe
William Dutton, directeur de l’Oxford Internet Institute de l’université d’Oxford, affirme dans Les fautes d’orthographe « coûtent des millions » en ventes en ligne perdues que, dans certaines parties informelles d’internet, comme Facebook, la tolérance envers l’orthographe et la grammaire est plus grande.
Cependant, d’autres aspects, comme une page d’accueil ou une offre commerciale, ne relèvent pas du cercle amical et soulèvent des préoccupations en matière de confiance et de crédibilité. Dans ces cas, un mot mal orthographié peut être rédhibitoire.
Le mot « préoccupations » a suffi à me convaincre. Au travail ! Pour la vérification orthographique
des documents Markdown, nous utilisons npm install --save markdown-spellcheck.
Il ne repère pas forcément la grammaire ni bien d’autres subtilités (« it’s » ou « its »), mais au moins, beaucoup de mes fâcheuses erreurs tenaces sont repérées avant d’arriver en production :
- mon propre anglais imaginaire (« symbiose » au lieu de « symbiosis »)
- des ratés tenaces (« editted » au lieu de « edited »), et
- le mélange d’anglais britannique et américain (« summarise » au lieu de « summarize »)
(pour ma défense : l’anglais n’est pas ma langue maternelle 😄)
Markdown-spellcheck ignore même automatiquement les blocs de code et d’autres éléments propres au
Markdown, mais nous avons évidemment dû ignorer manuellement des éléments comme Transloadit et FFmpeg
printf '%s\n' 'Transloadit' 'FFmpeg' >> .spelling
Nous sommes maintenant prêts à vérifier l’orthographe de nos fichiers Markdown
node_modules/.bin/mdspell \
  --report \
  --en-us \
  --ignore-numbers \
  --ignore-acronyms \
  **/*.md \
  _layouts/*.html \
  _includes/*.html \
  *.html
Cette commande pourrait signaler que « editted » n’est pas un mot.
Première exécution
Il y a de fortes chances que la première exécution révèle de nombreux problèmes, à la fois dans vos
documents et dans le dictionnaire. C’est pourquoi il est judicieux d’exécuter mdspell sans l’option --report
afin qu’il passe dans le mode interactif par défaut.
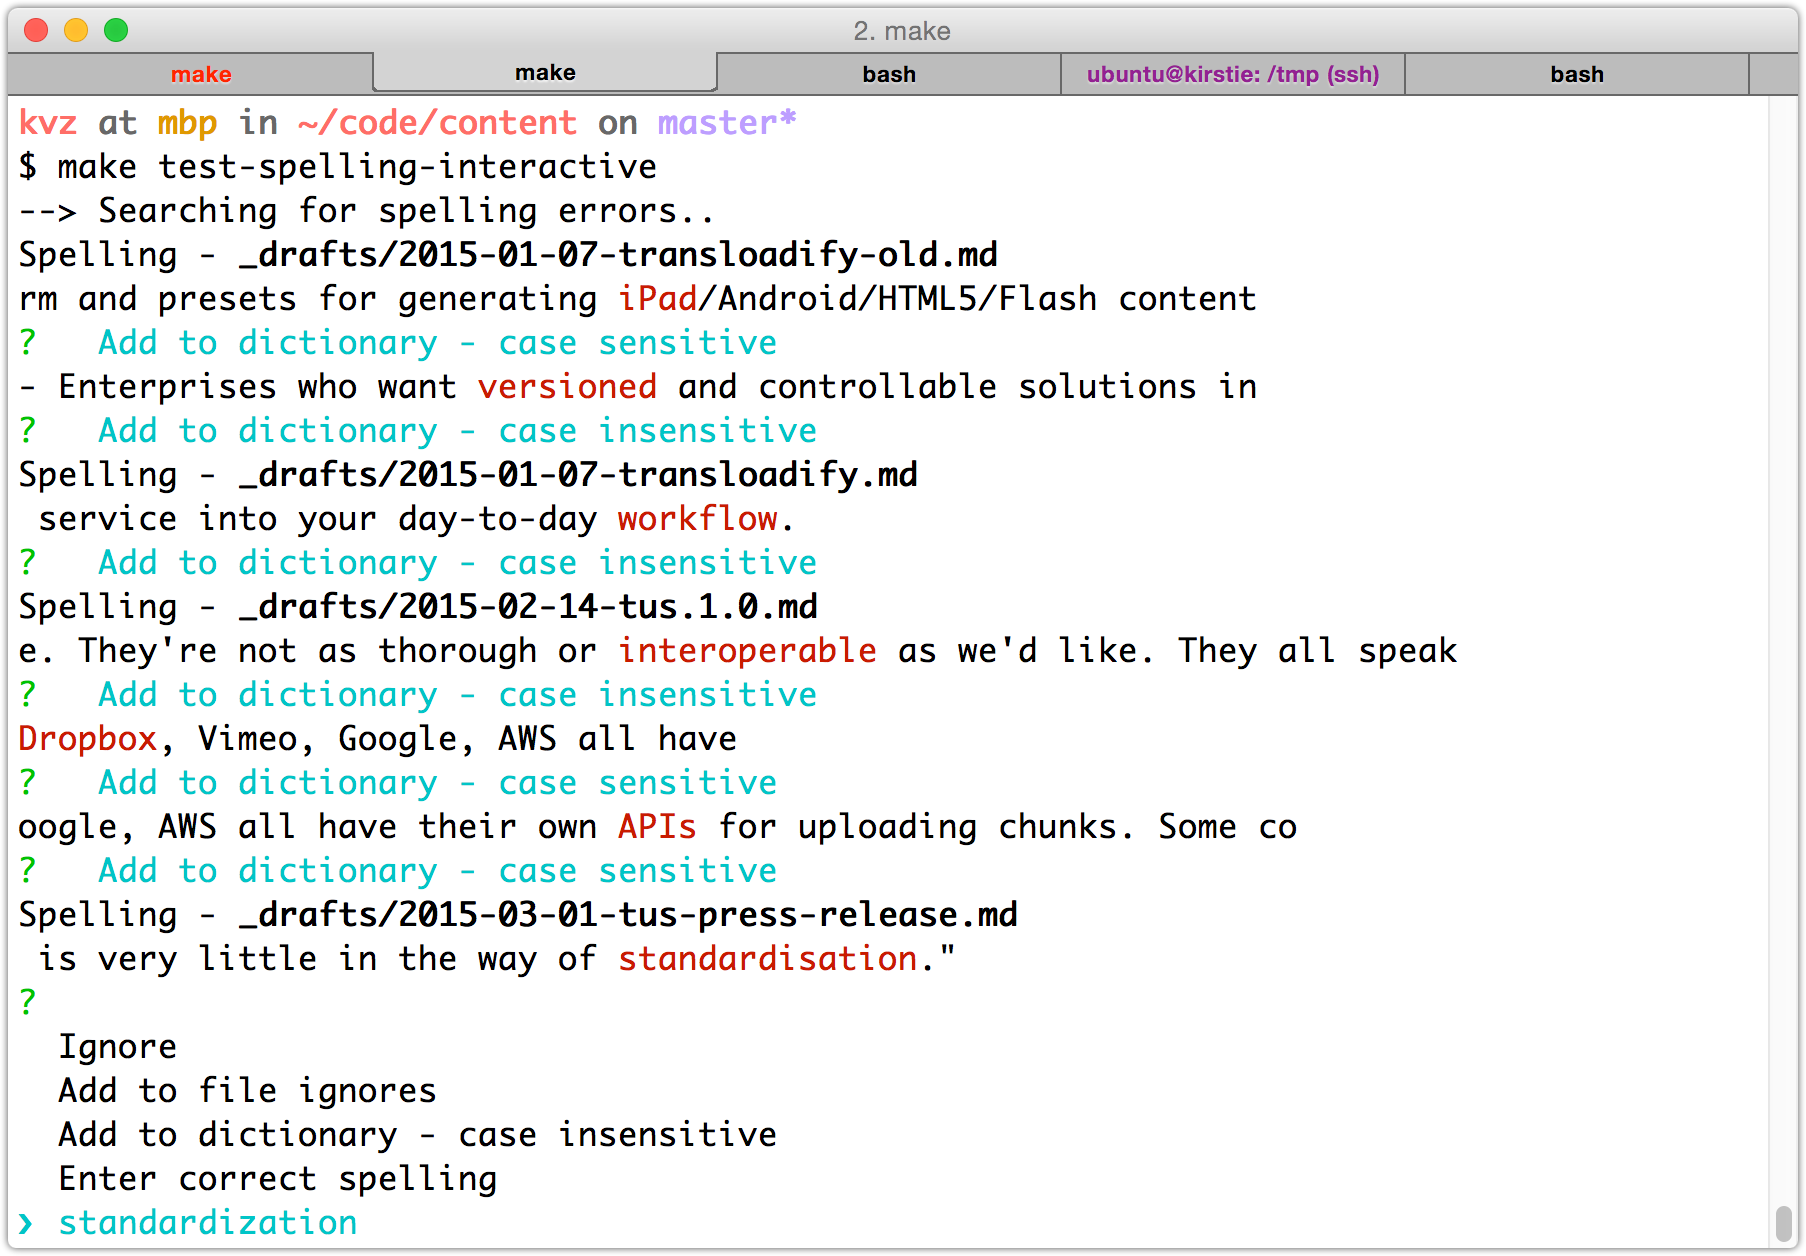
Vous pourrez ainsi exclure certains fichiers et constituer un dictionnaire personnalisé dans .spelling.
Cela prendra sans doute un moment, mais peut devenir une excellente activité lorsque vous voulez
être productif lors d’un après-midi par ailleurs peu inspiré.
À mesure que vous ajoutez du contenu, vous devrez parfois aussi ajouter des mots à la liste d’autorisation. Mais au moins, vous saurez que chaque écart par rapport au dictionnaire sera délibéré. Et c’est une sensation agréable.
Tout combiner
Assemblons maintenant le tout.
Comme nous avons installé tous ces outils depuis npm, il pourrait être logique d’utiliser des scripts npm run. Dans notre cas, j’ai toutefois choisi un Makefile, simplement parce que nous aimons naviguer à coups de TAB dans l’autocomplétion du shell, et pour disposer du même point d’entrée développeur dans tous nos projets, qu’ils soient écrits en Node.js, Bash ou Go.
SHELL := /usr/bin/env bash
tstArgs :=
tstPattern := **/*.md _layouts/*.html _includes/*.html *.html

.PHONY: fix-markdown
fix-markdown:
	@echo "--> Fixing Messy Formatting.."
	@node_modules/.bin/mdast --output .

.PHONY: test-inconsiderate
test-inconsiderate:
	@echo "--> Searching for Inconsiderate Writing (non-fatal).."
	@node_modules/.bin/alex $(tstArgs) || true

.PHONY: test-spelling
test-spelling:
	@$(MAKE) test-spelling-interactive tstArgs=--report

.PHONY: test-spelling-interactive
test-spelling-interactive:
	@echo "--> Searching for Spelling Errors.."
	@node_modules/.bin/mdspell \
	  $(tstArgs) \
	  --en-us \
	  --ignore-numbers \
	  --ignore-acronyms \
	  $(tstPattern)

.PHONY: test-markdown-lint
test-markdown-lint:
	@echo "--> Searching for Messy Formatting.."
	@node_modules/.bin/mdast --frail $(tstArgs) .

.PHONY: test
test: test-inconsiderate test-spelling test-markdown-lint
	@echo "All okay : )"
Nous pouvons maintenant exécuter make test pour vérifier que tous nos contrôles passent.
Nous pouvons exécuter make test-spelling pour nous concentrer uniquement sur les fautes d’orthographe, ou
make test-spelling-interactive si nous voulons passer en mode interactif après avoir rédigé un contenu
comportant beaucoup de nouveaux mots qui ont peu de chances de figurer déjà dans le dictionnaire.
Si vous avez
Bash Completion, tapez simplement
make, appuyez sur TAB et découvrez tous les raccourcis disponibles.
Automatiser
Pour automatiser les tests, il nous faut un serveur d’intégration continue.
Travis CI, Strider et Drone.io font tous l’affaire. L’essentiel est de disposer d’un emplacement central qui exécute le code de manière fiable et reproductible à chaque modification de votre dépôt.
Nous utilisons Jenkins pour nos projets privés, et j’ai créé trois nouvelles tâches enchaînées pour notre dépôt de contenu :
content-buildtransforme notre Markdown en contenu HTML statique via Jekyll, puis déclenche :content-testexécute toutes les commandes de cet article, puis déclenche :content-injectstocke le HTML dans notre site web, puis déclenche :website-build,website-test,website-deploy. Une chaîne que nous avions déjà mise en place pour déployer notre site web.
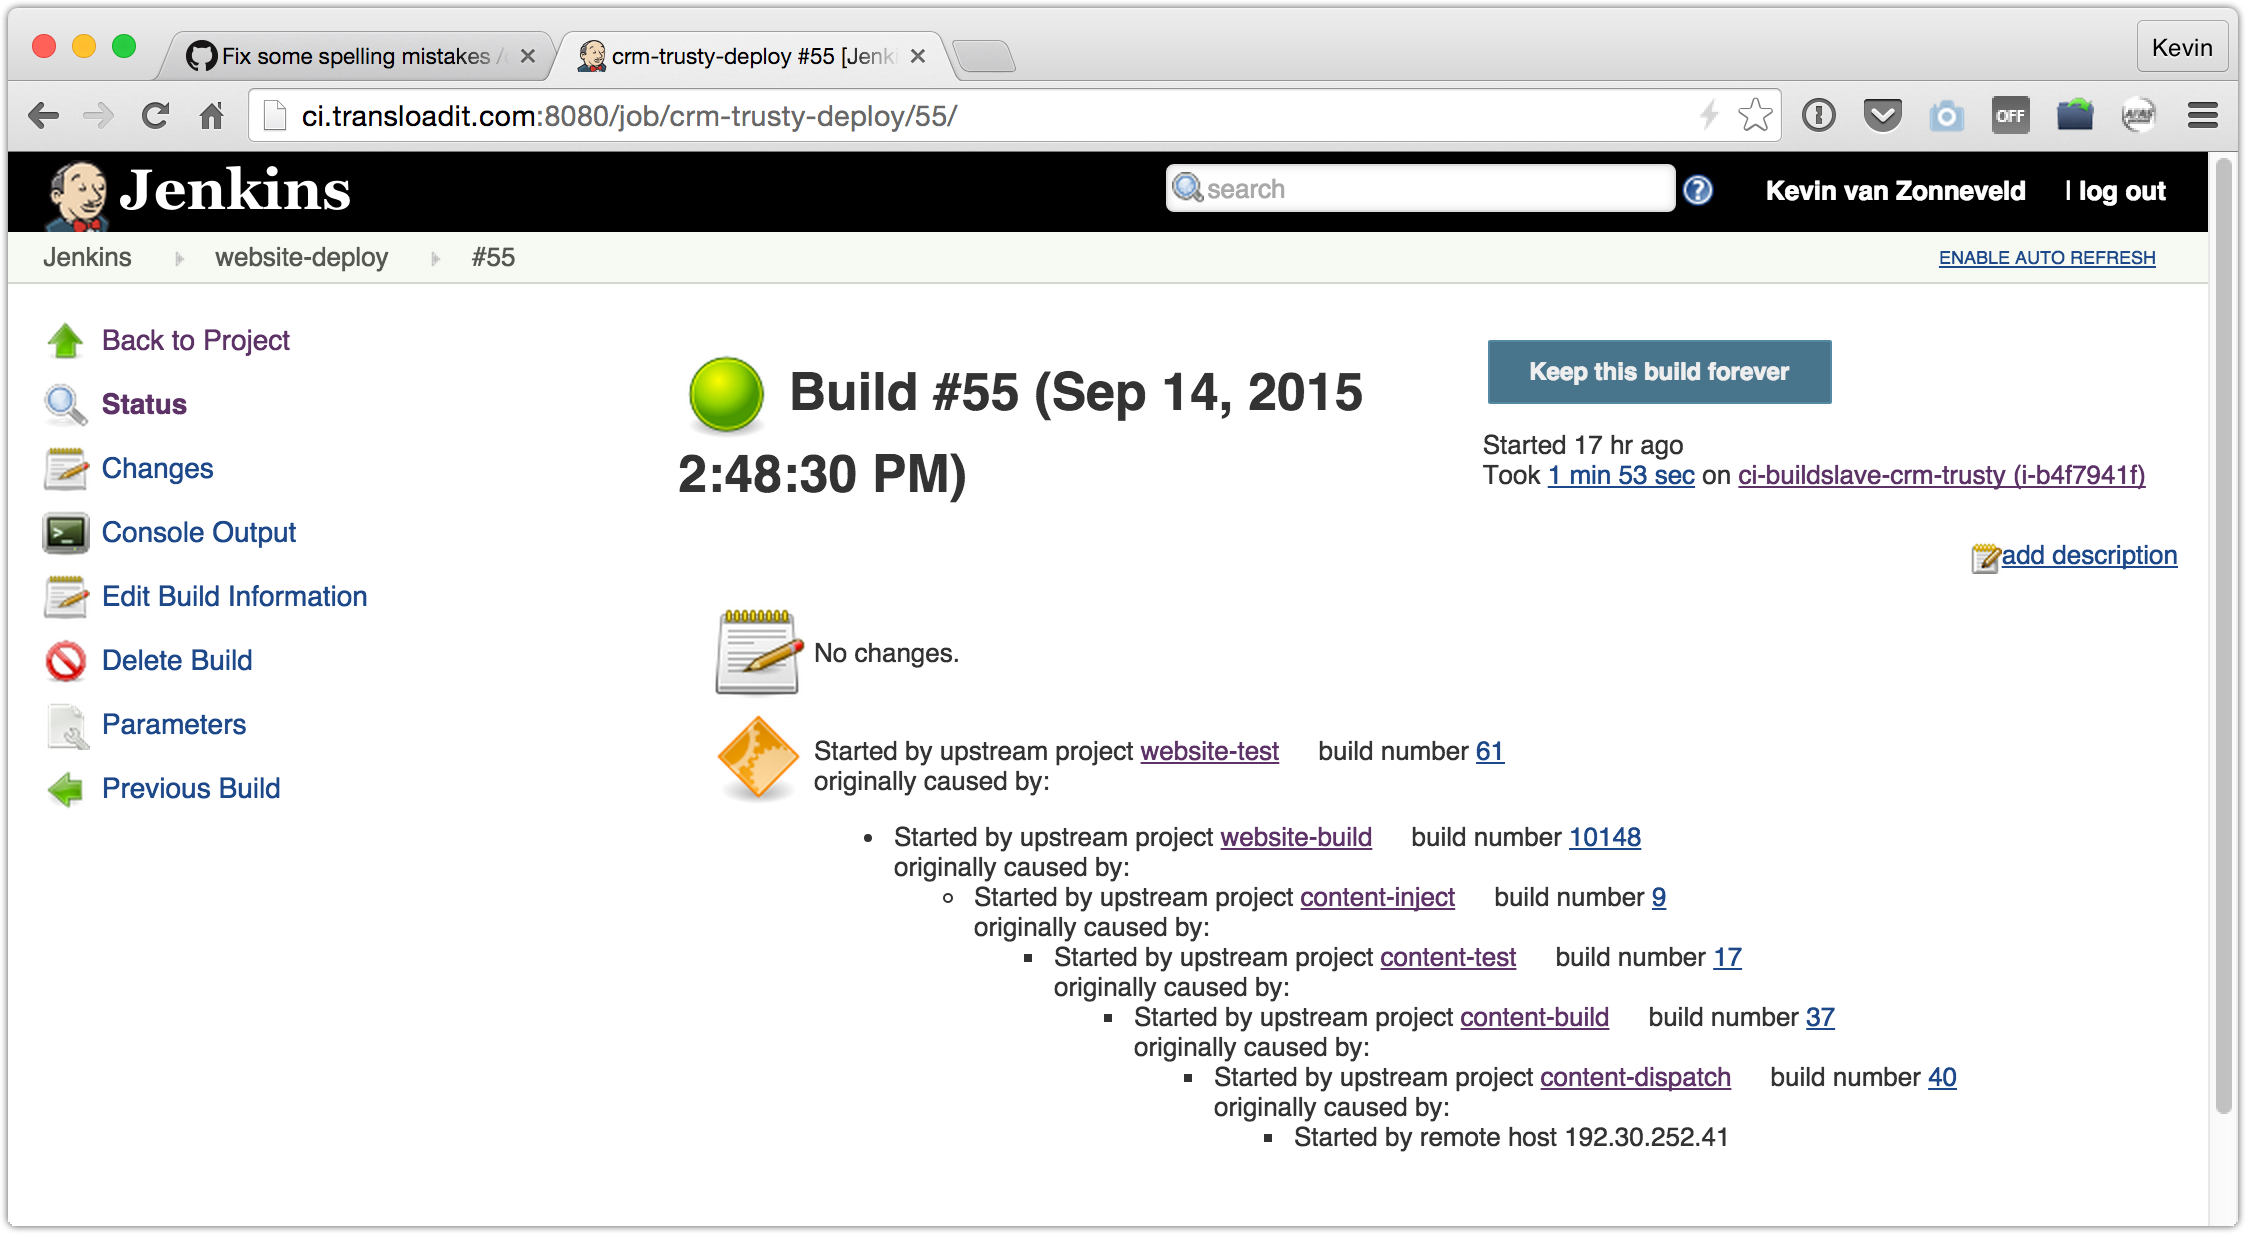
Un nouveau contenu ne peut désormais être injecté et déployé que si tous les contrôles passent. La chaîne est assez longue, mais heureusement, c’est une machine qui s’en charge. 😄
Et lorsque cette machine détecte des coquilles dans un nouveau contenu, une intégration Slack nous permet d’être avertis immédiatement.
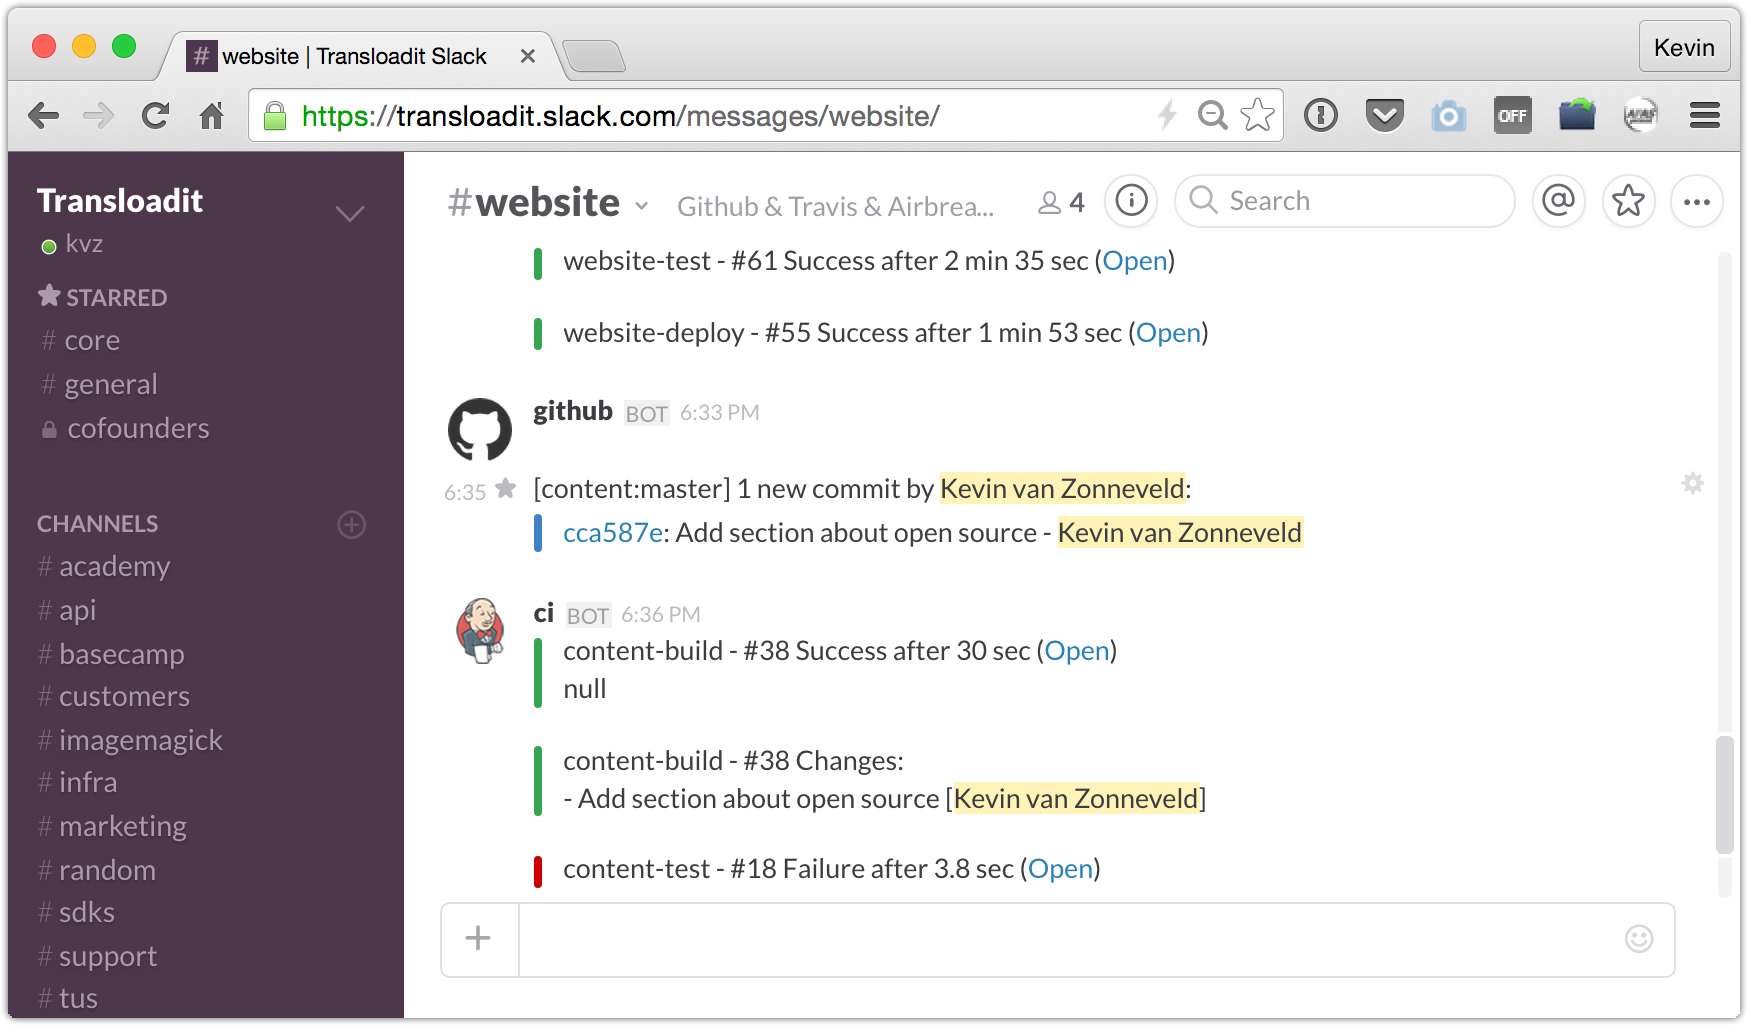
Est-ce parfait maintenant ?
Non. Les humains sont faillibles, tout comme leurs machines et leurs dictionnaires.
Nous devrons continuer à ajuster .spelling, et « lui » devra continuer à me corriger. Mais grâce à ce
contrôle qualité automatisé de la langue, nous nous surveillons mutuellement et faisons moins
d’erreurs qu’avant.
Chez Transloadit, nous avons pu corriger 151 erreurs lors de notre première exécution
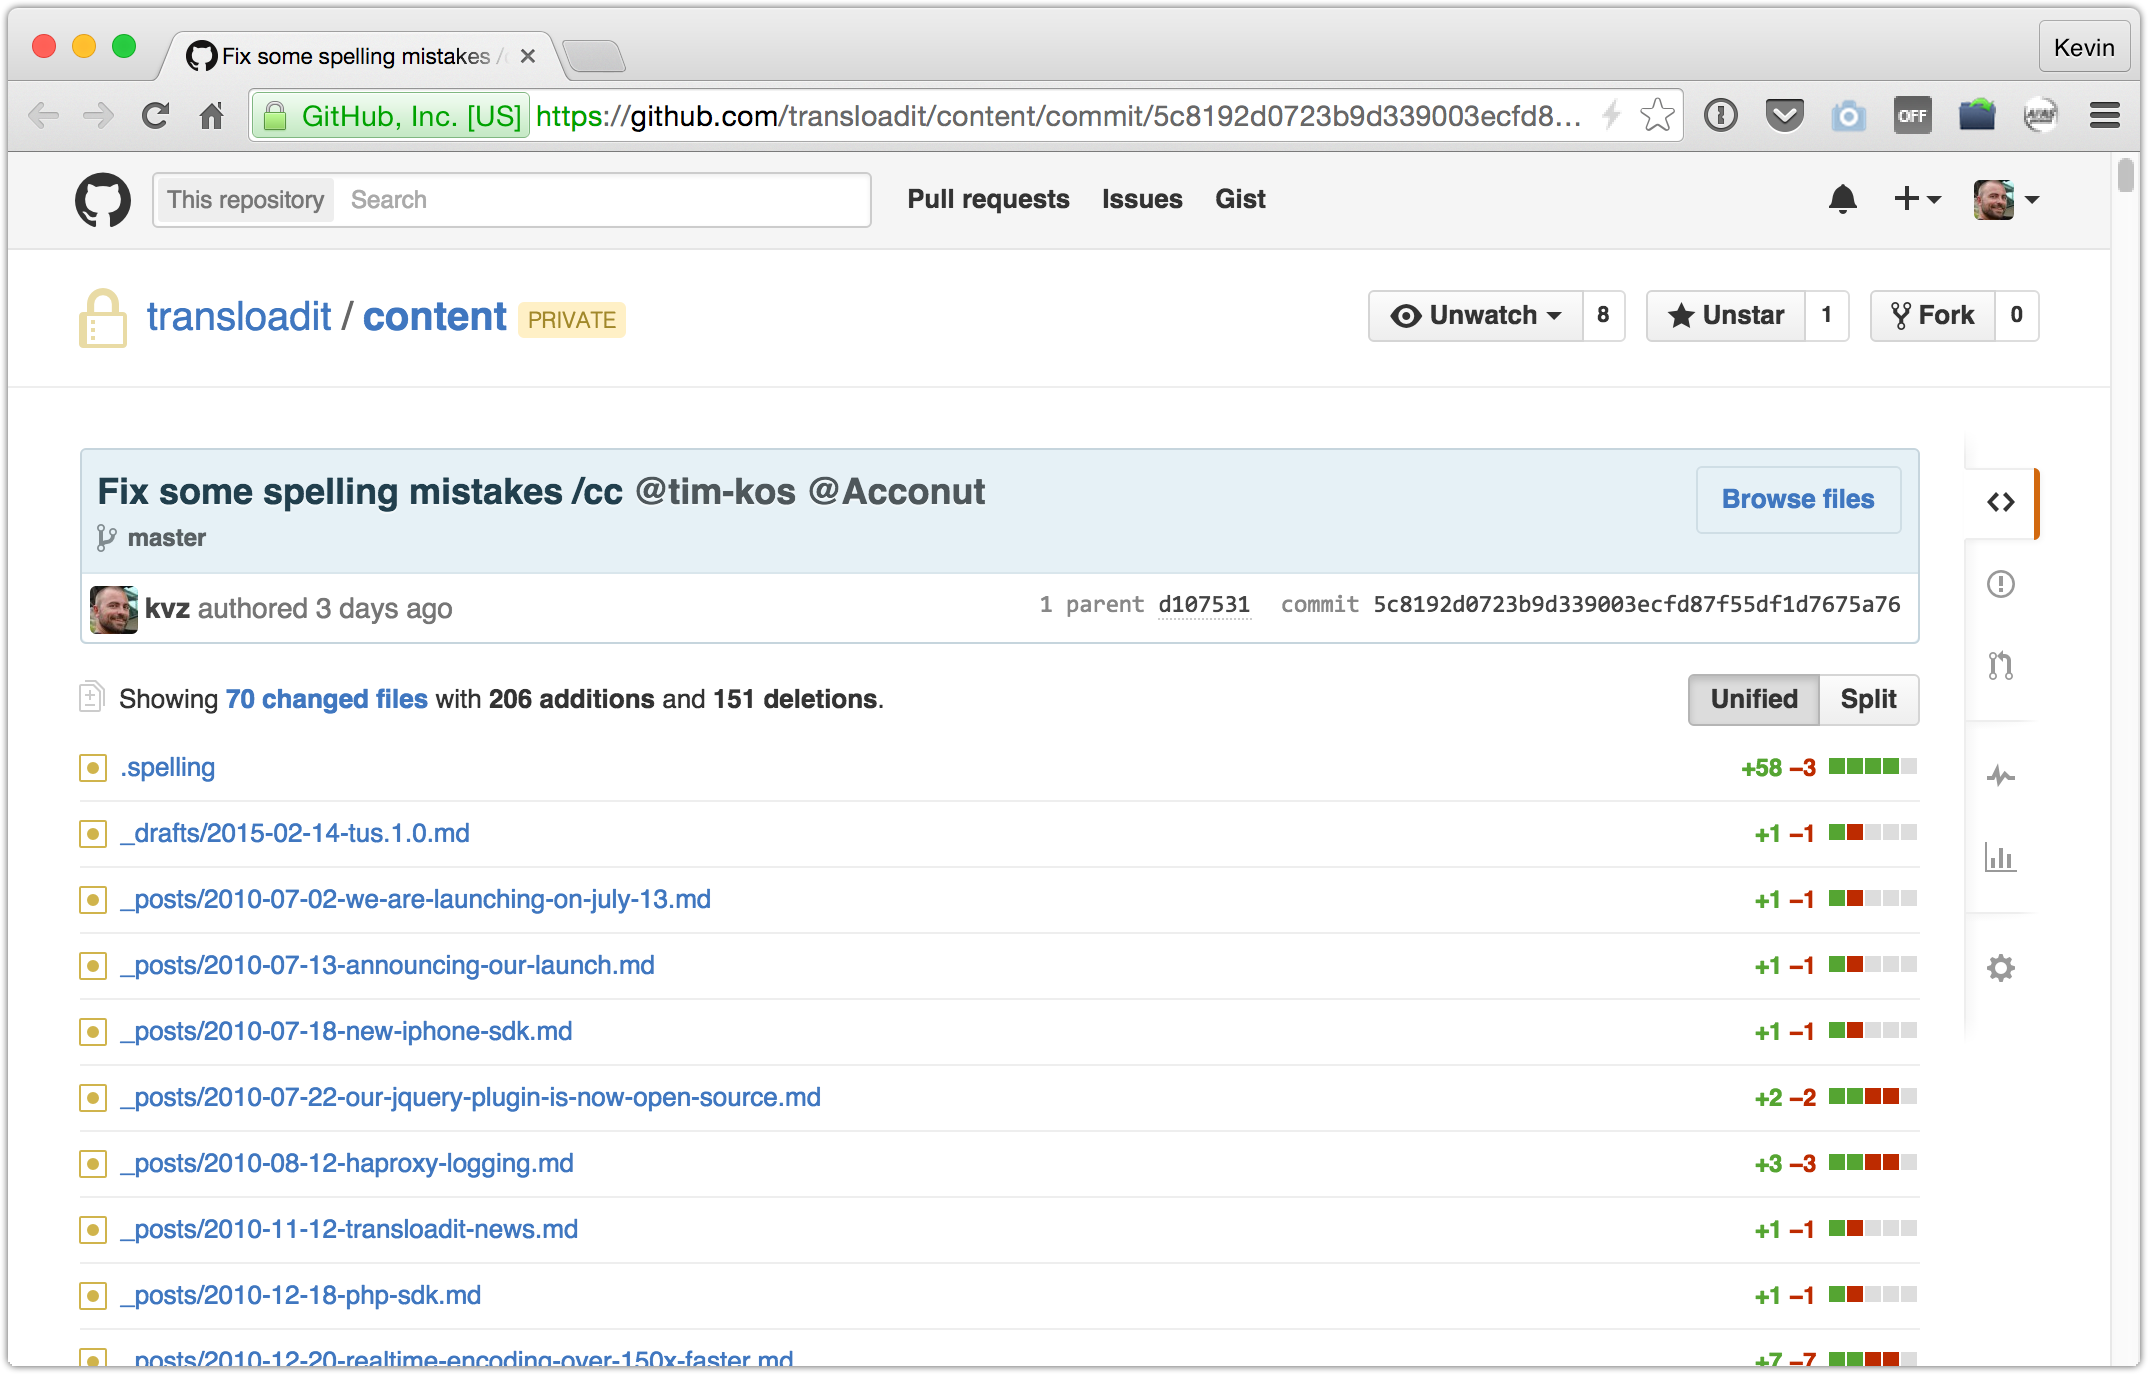
Eh oui… il s’avère que nous sommes étions vraiment mauvais en orthographe !
Et ensuite
Si vous connaissez d’autres outils de traitement Markdown intéressants à ajouter à notre chaîne de build, dites-le-nous sur Twitter ou en commentant sur HN.
Enfin, nous cherchons toujours un bon rédacteur technique pour nous aider à améliorer nos textes, car les ordinateurs ont leurs limites. 😄
Sachez que vous ne travailleriez que sur des fichiers Markdown : tout le reste est géré automatiquement. Écrivez-nous si cela vous intéresse !