
Résoudre les problèmes Redis pour plus de stabilité et de vitesse

Il arrive que les choses tournent mal chez Transloadit. Dans ce cas, nous tenons à faire preuve de transparence et à reconnaître nos erreurs. C’est dans cet esprit que je vous informe d’un problème qui a touché 81 de nos clients la semaine dernière.
En début de semaine dernière, nous avons reçu des signalements faisant état d’une hausse des erreurs
WORKER_JOB_ERROR. Cela nous indique un problème de communication entre nos Uploaders (les machines qui
reçoivent les fichiers et orchestrent les Assemblies) et nos Drones (les machines qui
exécutent les tâches d’encodage).
Nous avons signalé le problème sur Twitter et sur transloaditstatus.com, puis nous avons commencé nos recherches.
En tant qu’auteurs du module retry, nous avons mis en place des nouvelles tentatives pour de nombreux processus chez Transloadit. Cela signifie aussi que presque toutes les Assemblies peuvent être relancées sans perte de données. Dans quelques cas, toutefois, des Assemblies n’ont pas pu être relancées, et dans beaucoup d’autres, elles étaient simplement beaucoup plus lentes, car les nouvelles tentatives avec temporisation exponentielle se déclenchaient en cas d’erreur.
Après avoir épluché nos journaux et débogué le code, il est apparu que nous perdions des Jobs placés en file d’attente dans le cluster Redis régional us-east, ainsi que des signaux de vie (heartbeats) échangés entre les Uploaders et les Drones mentionnés plus haut. La surveillance de ces signaux de vie nous permet de confier un Job à un autre Drone si le Drone d’origine cesse de les émettre.
Nous avons immédiatement appliqué une solution de fortune en réinjectant les messages perdus et en assouplissant la surveillance des signaux de vie. Cette approche ne faisait cependant que combattre les symptômes, au lieu de s’attaquer à la racine du problème. De plus, elle se faisait au prix de temps d’exécution d’Assembly plus longs. Autrement dit, il fallait aller plus loin.
Le plan d’action
L’équipe s’est donc réunie et plusieurs de ses membres ont exploré différentes pistes pour établir la cause profonde du problème. Plus précisément, nous avons :
- Vérifié si nous étions passés à côté de correctifs Redis critiques, puis effectué la mise à niveau vers la dernière version stable.
- Réalisé un audit complet du code de notre bibliothèque côté client et évalué la manière dont nous l’utilisons.
- Amélioré notre surveillance, nos métriques, nos alertes et nos entrées de journal. De nombreuses métriques sont déjà surveillées, mais nous ne pouvons configurer des alertes pertinentes que pour un nombre limité d’entre elles. Il est possible que notre sélection ait été insuffisante.
Lorsque l’équipe s’est de nouveau réunie pour partager ses conclusions, des problèmes avaient été identifiés sur plusieurs fronts :
- Nous n’utilisions pas la dernière version de Redis, dans laquelle plusieurs bugs inquiétants
avaient été corrigés, dont certains marqués
[FIX] Fixed data loss. - L’équipe n’a trouvé aucun problème dans la version récente de la bibliothèque côté client que nous utilisions. ✅
- Nous suivions notamment le nombre de commandes Redis, les connexions et l’utilisation du swap, mais pas la bande passante. Nous utilisions un cluster de 3 nœuds aux États-Unis, et il semblait peu probable que nous saturions toutes leurs cartes réseau. En y regardant de plus près, cependant, c’est exactement ce qui se produisait.
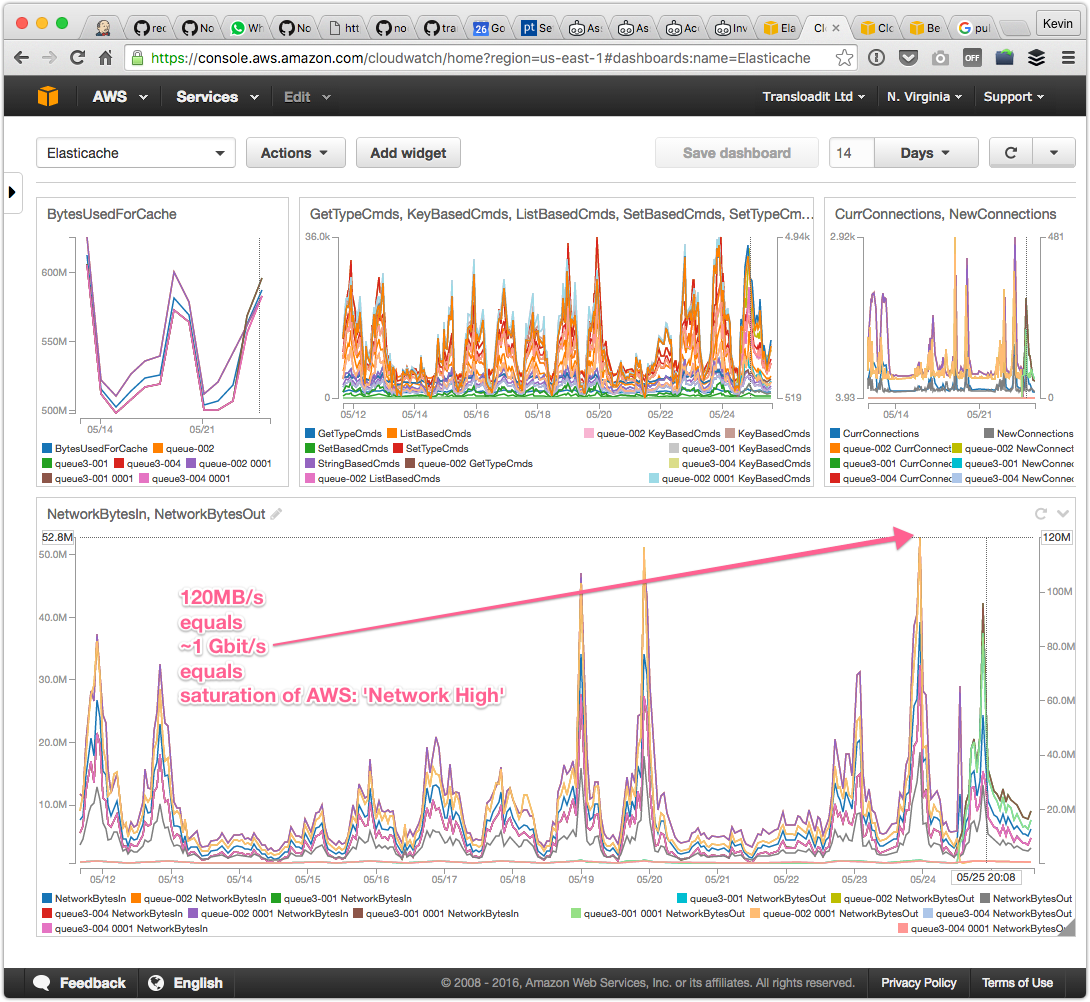
Dès qu’il est apparu que la bande passante nous bridait, nous avons doublé la taille de notre cluster. Cela devait répartir la charge sur six nœuds Redis, pour un débit de lecture total de ~6Gbit/s. Nous étions convaincus que ce serait largement suffisant.
Nous avons alors constaté une hausse immédiate de la consommation de bande passante :
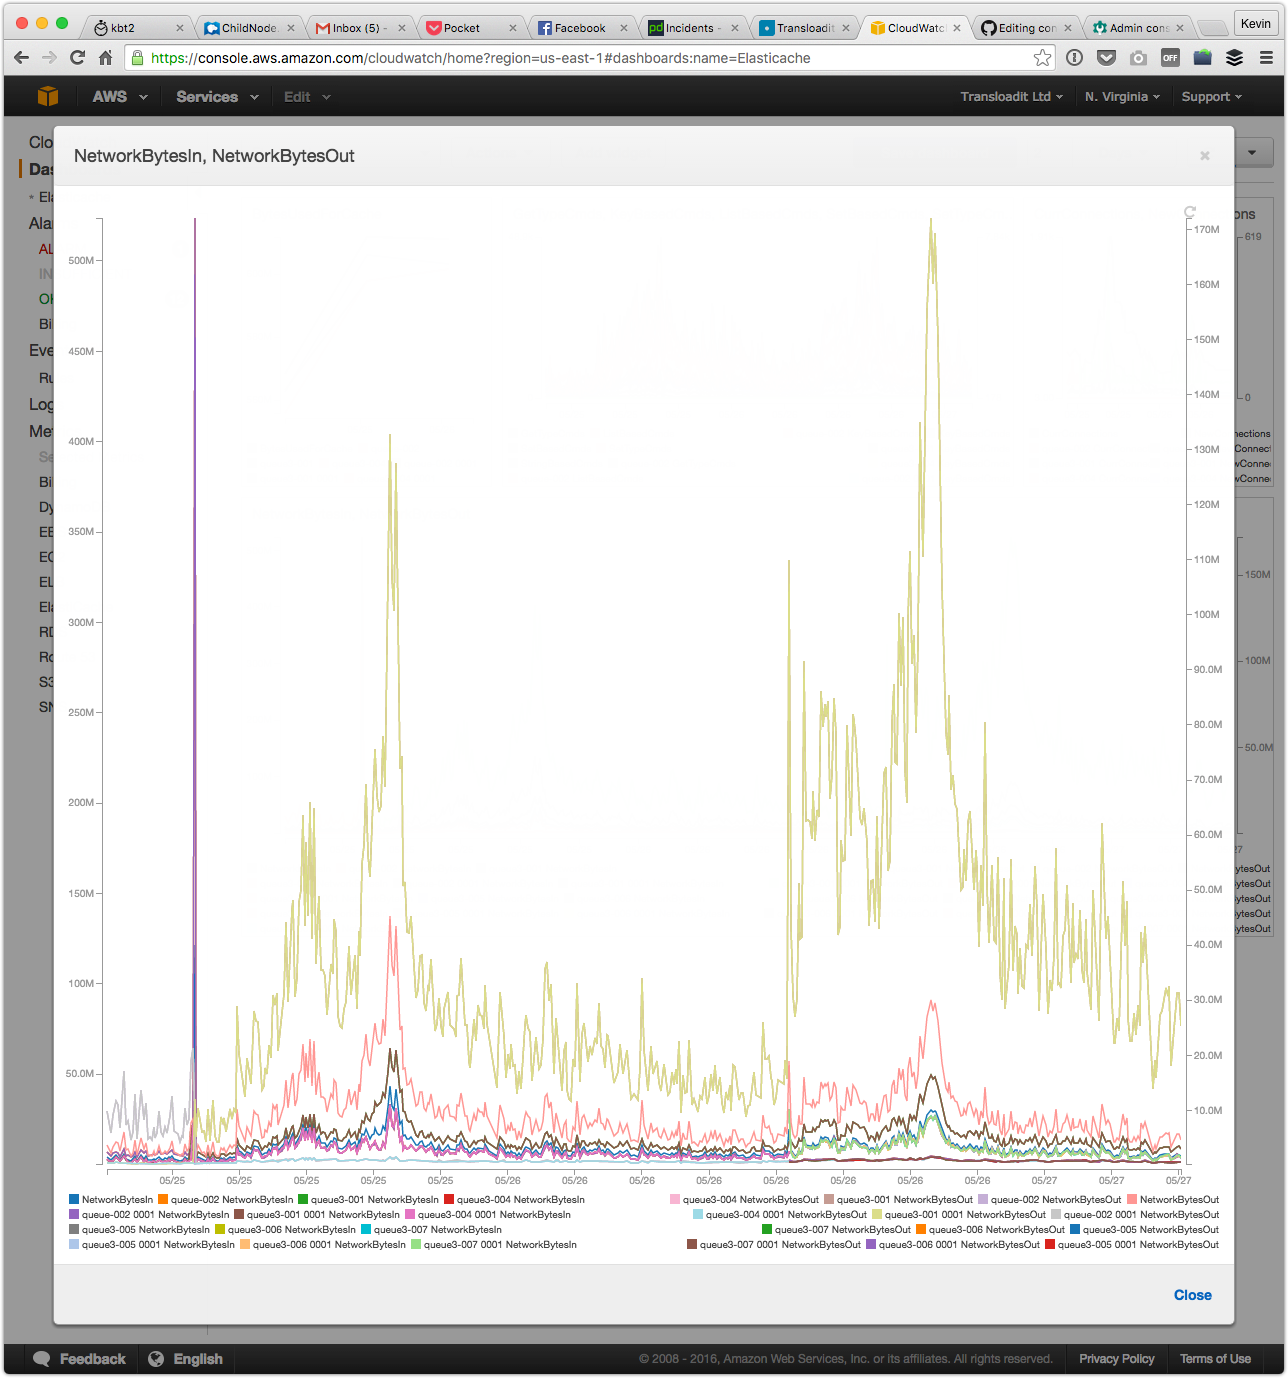
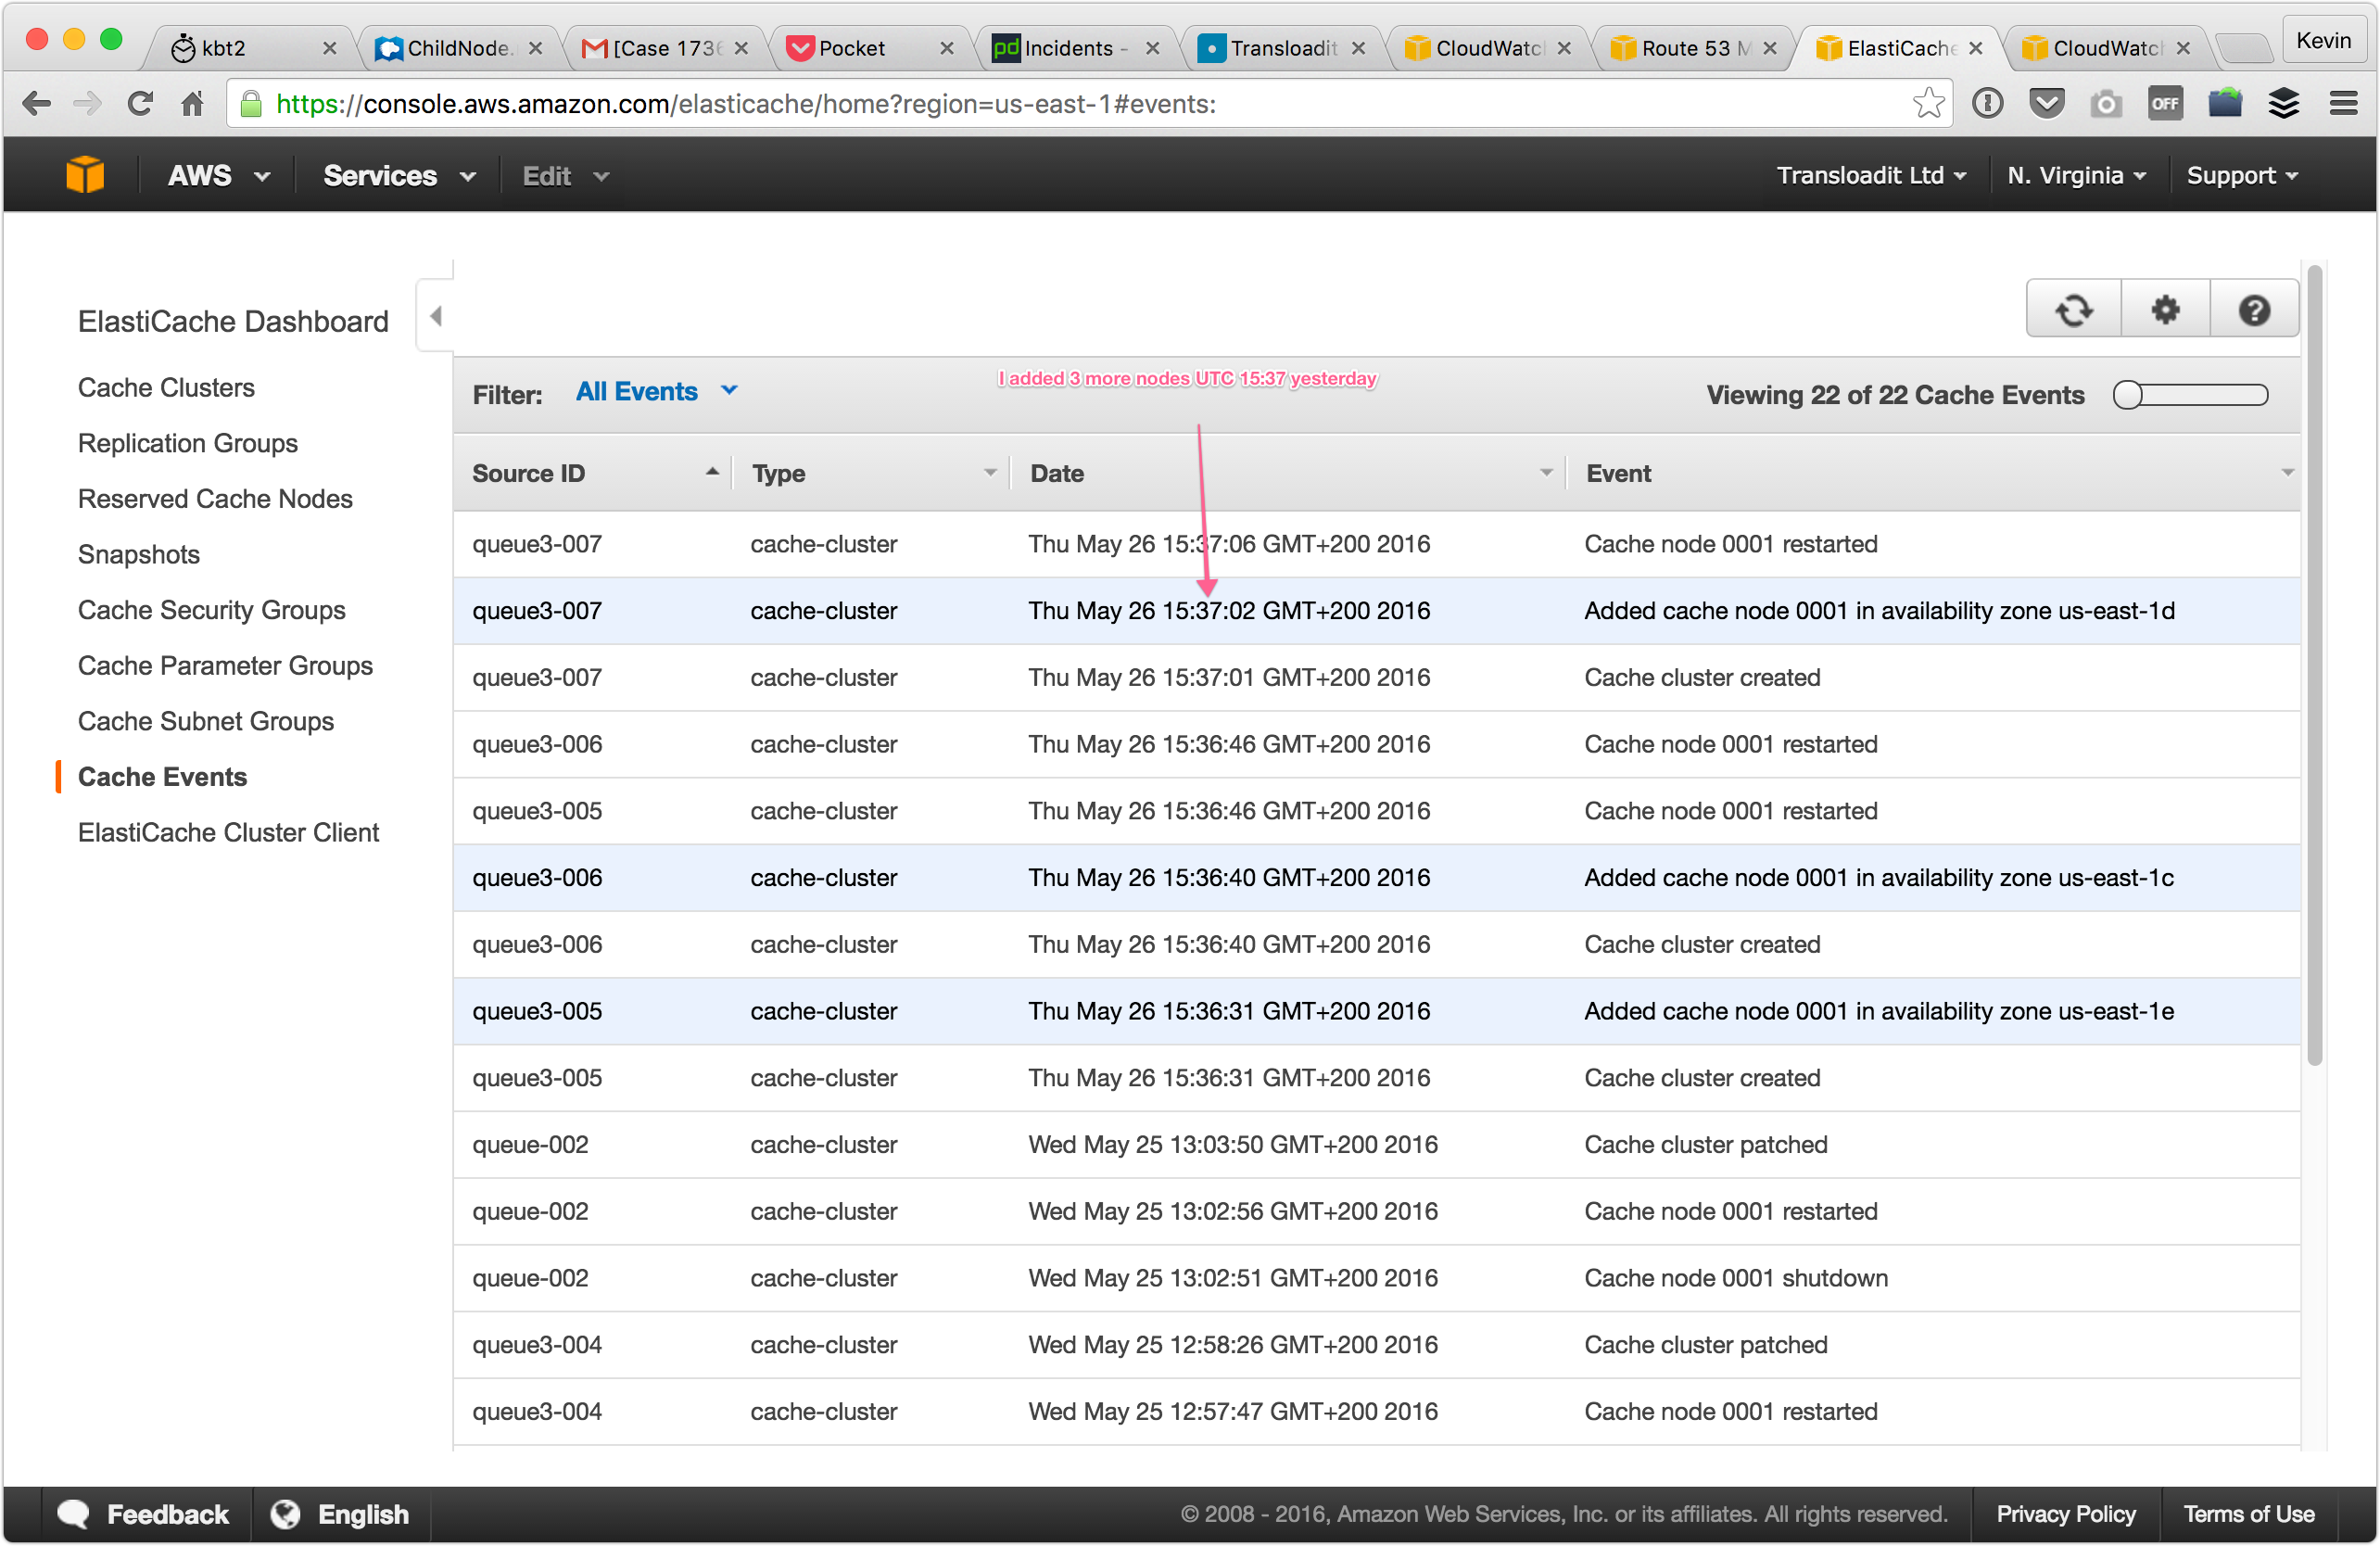
La consommation atteignait toutefois rapidement de nouveaux seuils de saturation, et de nombreuses Assemblies restaient lentes. Nous avons d’abord pensé que nous sous-estimions encore la taille nécessaire de notre cluster. Nous avions été bridés par les limites de trois nœuds Redis, et comme six nœuds Redis ne semblaient pas suffire non plus, nous en avons ajouté trois autres pour voir l’effet sur la consommation de bande passante.
À notre grande surprise, cela n’a fait qu’empirer les choses. En y regardant de plus près, nous avons remarqué que l’essentiel du trafic sortant provenait du nœud leader du cluster. À ~4Gbit/s, il émettait désormais bien plus de trafic que ce qu’Amazon annonce comme possible (ce qui pourrait faire l’objet d’un prochain article de blog), tandis que le trafic des autres nœuds Redis restait largement dans les limites.
C’était étrange, car le trafic sortant (les lectures) devrait être réparti sur l’ensemble du cluster. Pourquoi le leader en générait-il autant ? En dehors de la gestion des écritures et du Pub/Sub, il n’aurait dû émettre qu’environ un neuvième du trafic sortant total.
Moins, c’est mieux
C’est alors que nous avons compris : la réplication. Chaque écriture passait par le leader, qui, au lieu de synchroniser les données écrites vers deux nœuds Redis, devait désormais les synchroniser vers huit nœuds Redis. Comme Redis ne dispose pas d’un protocole sophistiqué tel que gossip, tout ce que nos Drones envoyaient devait maintenant être copié vers huit nœuds au lieu de deux (ce qui posait déjà problème). Cela représente quatre fois plus de travail et de trafic sortant pour ce seul leader Redis.
Pour ne rien arranger, nos données sont très intensives en écriture et extrêmement volatiles. Elles ne sont utiles que pendant un bref instant. Une fois copiées, elles devaient donc aussi être supprimées peu de temps après.
Comme nous pouvons réinjecter les données manquantes, nous nous sommes demandé si la réplication, en apparence une bonne idée, était réellement nécessaire.
Idéalement, nous aimerions n’avoir aucun trafic de réplication et basculer vers un nœud Redis vierge en cas de défaillance. Avec AWS Elasticache, cependant, la réplication est obligatoire pour le basculement automatique. Fort de ce constat, nous avons réduit le nombre de réplicas en lecture à un seul. Nos journaux ont aussitôt montré une baisse du trafic comme du taux d’échec, et les Assemblies ont de nouveau commencé à s’accélérer.
Souffler
La cause profonde enfin trouvée, nous avons pu souffler et avons commencé à nous demander comment cela avait pu arriver. La situation était quelque peu déroutante, car nous ne trouvions aucune modification de notre code ou de notre infrastructure qui expliquerait la saturation soudaine de notre capacité Redis.
Nous avons toutefois remarqué deux changements dans l’environnement :
- Une forte hausse du trafic HLS. HLS découpe les vidéos volumineuses en de nombreux petits fragments, ce qui permet aux utilisateurs mobiles de télécharger le segment vidéo suivant dans la qualité optimale pour leur connexion du moment (en se dégradant progressivement jusqu’à l’audio seul lorsque la connexion devient vraiment mauvaise). Cela peut facilement multiplier par mille les métadonnées échangées pour chaque vidéo.
- Nous pouvons avoir davantage de Drones en ligne pour traiter le même volume en moins de temps. Cela entraîne naturellement une charge accrue sur les nœuds centraux.
C’est la combinaison de ces deux changements qui a révélé ce goulot d’étranglement dans notre infrastructure. Nous avons ensuite fait le mauvais choix en augmentant le nombre de nœuds Redis pour atténuer le problème, mais il s’est avéré que davantage de machines pesaient en réalité sur le débit. Pour pouvoir absorber plus de trafic, nous devions utiliser moins de nœuds.
Perspectives
À l’issue de notre enquête approfondie, tous les composants logiciels mentionnés ci-dessus ont été mis à niveau : nous ne sommes donc plus exposés aux bugs connus susceptibles d’entraîner une perte de signaux de vie ou de données, en dehors des problèmes de bande passante que nous avons rencontrés. Nous avons également mis en place une journalisation et des alertes supplémentaires au cas où nous approcherions de nouveau des niveaux de saturation.
Le trafic entre les nœuds Redis, nos Drones et nos Uploaders était légitime : nous devrons donc chercher des moyens de décentraliser ce trafic. La réduction du trafic de réplication nous a peut-être fait gagner du temps, mais nous voulons pouvoir soutenir une croissance impossible avec un seul nœud Redis acceptant les écritures. Même en passant à l’échelle verticalement (avec un seul nœud Redis plus puissant) sans réplication, un nouveau goulot d’étranglement se profilerait dangereusement tôt.
Nous avons envisagé des réplicas en lecture de réplicas en lecture, ce qui permettrait de répartir le trafic de réplication, mais, si notre croissance se poursuit, cela ne nous ferait gagner que quelques mois de plus. De plus, comme nous sommes limités par les écritures et que ces écritures doivent rester sur une seule machine, cette option est totalement exclue.
Nous avons aussi envisagé de migrer vers un autre magasin de données (distribué) optimisé précisément pour cet usage, mais une migration d’une telle ampleur prendrait très probablement des semaines, voire des mois. C’est du temps que nous n’avons tout simplement pas. Changer de magasin de données en pleine exploitation est déjà assez délicat, a fortiori dans l’urgence.
Le sharding (partitionnement) semble être notre meilleure option à ce stade. Il permet de cloisonner les données en différents groupes logiques et d’exécuter chaque groupe sur un matériel distinct (ou sur le même, mais c’est vous qui décidez). D’autres entreprises partitionnent souvent par client. Nous partitionnons déjà par région et prévoyons désormais d’ajouter un partitionnement supplémentaire par Uploader. Le partitionnement par client nous semble moins adapté à notre configuration, car un seul client effectuant un import volumineux pourrait à lui seul saturer Redis. Nous faisons toutefois déjà évoluer le nombre d’Uploaders en fonction des pics de trafic : nous gagnerons donc progressivement en capacité Redis à mesure que le trafic augmente. Le trafic est étiqueté avec le nom de l’Uploader, ce qui permettra aussi de savoir clairement quel nœud Redis doit être sollicité.
Les travaux ont déjà commencé et nous prévoyons un lancement cette semaine. En attendant, nous avons plafonné la montée en charge des Drones dans chaque région. Les imports par lots volumineux pourraient donc prendre un peu plus de temps que prévu, mais le système restera stable.
Nous sommes désolés
Nous comprenons que des temps d’exécution lents puissent être très frustrants, tout comme le fait de devoir relancer manuellement des Assemblies qui ne l’ont pas été automatiquement. Nous vous présentons nos excuses les plus sincères et offrons une semaine de service gratuit à ceux d’entre vous qui ont été fortement touchés. Merci de nous contacter et nous ferons le nécessaire. Bien sûr, un remboursement n’est probablement pas ce qui vous préoccupe : ce qui compte, c’est un service fiable. Nous espérons néanmoins que ce geste atténuera un peu la gêne occasionnée et qu’il montrera à quel point nous prenons ce type de problème au sérieux.