
Gains de performance majeurs pour des Assemblies plus rapides

Nous avons le plaisir d’annoncer qu’au cours des dernières semaines, nous avons apporté d’importantes améliorations de performance, grâce auxquelles l’Assembly moyenne s’exécute environ 20 à 40 % plus vite.
« Banc d’essai »
Nous avons effectué quelques tests d’envoi de 1, 5, 10 et 20 images sur notre page de démonstration /image/resize (English). C’est sommaire, mais cela montre déjà l’ampleur de nos progrès. Voici un gist avec les résultats. Tous les chiffres qu’il contient incluent le temps d’envoi et le temps d’encodage.
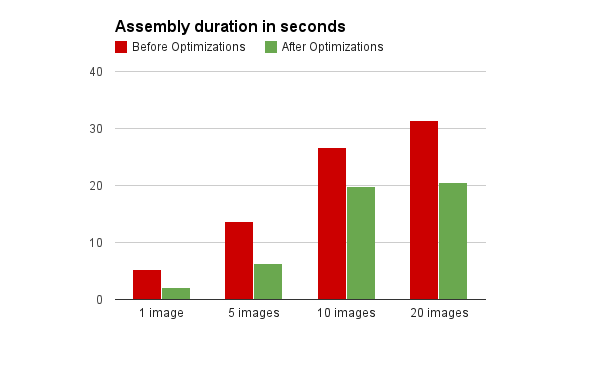
Vous pouvez constater une amélioration de 54 % pour 5 images, de 25 % pour 10 images et de 34 % pour 20 images. Pour 1 image, nous avons même observé une hausse de la vitesse de 60 %. Le gain de performance diminue à mesure que vous envoyez davantage de fichiers, car pendant que certains fichiers sont encore en cours d’envoi, les autres sont déjà convertis. La perte de temps est donc moindre, même avec la version non optimisée. Moins l’Assembly contient de fichiers, plus le gain de performance est visible.
Cela signifie aussi que pour votre Assembly moyenne, avec un seul fichier ou seulement quelques-uns, vous constaterez une hausse de vitesse spectaculaire.
Comment avons-nous fait ?
Pour les lecteurs curieux, nous aimerions expliquer comment nous y sommes parvenus. 😄
Nous avons apporté plusieurs mises à niveau importantes à notre système afin de l’optimiser. Même si nous sommes fiers que tous nos encodages et toutes nos manipulations de fichiers s’exécutent déjà en parallèle lorsque c’est possible, une telle amélioration restait envisageable dans un autre domaine.
Lorsque vous envoyez des fichiers à notre service, nous devons d’abord en extraire les métadonnées afin de a) vous les renvoyer plus tard, b) permettre aux Robots de déterminer quels fichiers ils peuvent traiter et c) laisser le Robot /file/filter opérer sa magie.
Nous devons également stocker tous les fichiers envoyés et tous les résultats d’encodage dans nos buckets Amazon S3 temporaires pour la communication de machine à machine. Si une machine d’encodage a besoin d’un fichier, celui-ci doit être téléchargé depuis Amazon S3 et non depuis une autre machine d’encodage, sinon les limites d’E/S des machines pourraient facilement être dépassées et causer des problèmes.
Nous avons deux types de machines en production (en réalité davantage, mais cela n’a pas
d’importance pour cette optimisation) : les machines d’envoi et les encodeurs. Les machines d’envoi
se trouvent derrière notre répartiteur de charge, elles prennent en charge vos Assemblies entrantes
et placent des Jobs dans des files d’attente. Les encodeurs (machines d’encodage) récupèrent ces Jobs
et les encodent, avant de renvoyer leurs résultats. Une fois tous les résultats rassemblés, la
machine d’envoi qui gère votre Assembly en rend compte au client connecté ou envoie une
Notification si vous utilisez un notify_url.
Optimisation 1
Nous avons déplacé l’extraction des métadonnées des fichiers envoyés des machines d’envoi vers les encodeurs. Cela allège considérablement la charge des machines d’envoi et les rend plus réactives et plus fiables, ce qui constitue un avantage supplémentaire très appréciable. Comme notre parc se compose principalement d’encodeurs, nous consacrons désormais beaucoup plus de puissance de calcul à l’extraction des métadonnées. Cette tâche s’effectue donc beaucoup plus rapidement.
L’inconvénient est que les encodeurs doivent désormais d’abord télécharger les fichiers envoyés depuis les machines d’envoi, ce qui nous a obligés à construire un autre système de files d’attente pour cela (afin de garantir que les limites d’E/S ne soient pas dépassées). Il reste encore une marge d’amélioration, mais nous en parlerons dans une annonce distincte.
Optimisation 2
Désormais, ce sont aussi les encodeurs qui stockent les fichiers envoyés sur S3, au lieu des machines d’envoi. De plus, au lieu d’effectuer les deux tâches (stockage S3 et extraction des métadonnées) l’une après l’autre, nous avons apporté des modifications qui nous permettent désormais de les réaliser en parallèle. Ces modifications s’appliquent également aux fichiers de résultats d’encodage.
Optimisation 3
Récemment, nous avons remplacé notre logiciel S3 sous-jacent, l’outil AWS de Tim Kay,
par l’interface en ligne de commande AWS officielle. Tim Kay a fait un
travail remarquable en maintenant un utilitaire aws performant, mais Amazon lance
fréquemment de nouvelles fonctionnalités et de nouveaux centres de données, et si nous voulons rester
à jour, nous ne pouvons pas attendre de Tim Kay qu’il consacre chacune de ses heures libres à un outil
qu’il a mis gratuitement à disposition. Comme Transloadit semblait être devenu plus dépendant de cet
utilitaire que son propre auteur, nous avons jugé plus sûr et plus équitable de passer à la CLI
officielle d’Amazon.
La CLI AWS officielle exige toutefois que vous ajoutiez le bon paramètre --region à vos
appels, faute de quoi elle signale une erreur. Les buckets S3 dépendent de la région.
Nos clients ne définissent souvent pas le paramètre region lors des exportations vers leurs
buckets, et il n’existe aucun moyen de déterminer la région sans effectuer au préalable des requêtes
GetBucketLocation et de nouvelles tentatives coûteuses en temps.
Cela dit, les clients incluent souvent une chaîne de région dans le nom de leur bucket propre à une région. C’est également le cas des buckets temporaires régionaux de Transloadit, qui servent à la communication entre machines et concernent chaque Assembly.
Nous avons décidé d’appliquer une astuce simple : rechercher d’abord une région valide dans le nom du bucket et, si elle existe, l’utiliser comme région par défaut lors de notre première tentative.
Ce n’est bien sûr pas infaillible, mais nous sommes dans le domaine de l’optimisation des
performances, où les astuces sont permises. Quoi qu’il en soit, notre algorithme fonctionnel de
changement de région reste également en place, au cas où quelqu’un aurait des buckets américains
contenant eu-west-1 dans leur nom.
Rien qu’avec cela, nous avons pu réduire la durée d’une opération S3 de 2,5 s à 0,6 s, ce qui fait gagner un temps précieux à chaque étape.
Vous voyez ainsi que cela profite surtout aux Assemblies hors des États-Unis, qui contiennent des fichiers de petite taille et de nombreux Steps. Si vous êtes un client basé aux États-Unis qui sert aussi des utilisateurs en Europe, il s’agit là aussi d’Assemblies hors des États-Unis, et ce gain de performance vous concerne donc également.
Perspectives
Nous nous efforçons constamment de vous offrir un meilleur service et nous continuerons à proposer des mises à niveau qui amélioreront encore les performances du système. Restez à l’écoute !
P.-S. Nous tenons à saluer le travail de Tim Kay. Il est remarquable que l’outil qu’il a publié ait si bien fonctionné, avec 5 ans d’avance sur la CLI AWS. Si nous maîtrisions mieux le Perl, nous aurions contribué à sa maintenance et l’utiliserions probablement encore.