

AI Robot による PDF からのテキスト抽出のご紹介

以前から、通常の Robot の機能を超える、AI を活用した Robot を提供しています。たとえば、画像内の顔を自動認識する働き者の /image/facedetect Robot は、すでにご存じの方も多いかもしれません。画像内の顔を特定し、ユーザーのプロフィール画像用に切り抜くのに最適です。
本日は、AI Robot の新たな仲間、/document/ocr Robot をご紹介します。
お気づきの方もいるかもしれませんが、すでに /image/ocr Robot も提供しています。両者の役割は似ていますが、明確な違いがあります。
内部の仕組みを見ると、/document/ocr Robot は AWS Textract と GCP Document AI を利用しています。これらは、小説や学術論文に見られるような長文のドキュメントや大量のテキストを扱うために特化して学習されています。さらに、表やフォームからのテキスト抽出にも優れ、たとえば請求書の処理にも適しています。
一方、/image/ocr Robot は Amazon Rekognition と GCP の Vision API を利用しています。どちらも、一時停止標識や荷物のラベル、名札などにある短いテキストを対象に学習されています。
ただし、最も重要な違いは、/document/ocr Robot が PDF に対応している点でしょう。クライアントから届く重要なドキュメントの処理に最適です。
テキストの抽出
こうした違いを理解するには、いつものように、説明だけでなく実際に_お見せする_のが一番です。そこで、/document/ocr Robot と /image/ocr Robot の出力の違いを見てみましょう。
最初の Template では、/image/ocr Robot を使います。
{
  "steps": {
    ":original": {
      "robot": "/upload/handle"
    },
    "detect": {
      "robot": "/image/ocr",
      "use": ":original",
      "provider": "aws",
      "format": "meta",
      "granularity": "full"
    },
    "exported": {
      "use": "detect",
      "robot": "/s3/store",
      "credentials": "my_s3_credentials"
    }
  }
}
次の Template では、/document/ocr Robot を使います。
{
  "steps": {
    ":original": {
      "robot": "/upload/handle"
    },
    "detect": {
      "robot": "/document/ocr",
      "use": ":original",
      "provider": "aws",
      "format": "meta",
      "granularity": "full"
    },
    "exported": {
      "use": "detect",
      "robot": "/s3/store",
      "credentials": "my_s3_credentials"
    }
  }
}
以下の画像は、両方の Template から得たバウンディングボックスを、サンプルの請求書に重ねたものです。左が /image/ocr、右が /document/ocr の結果です。
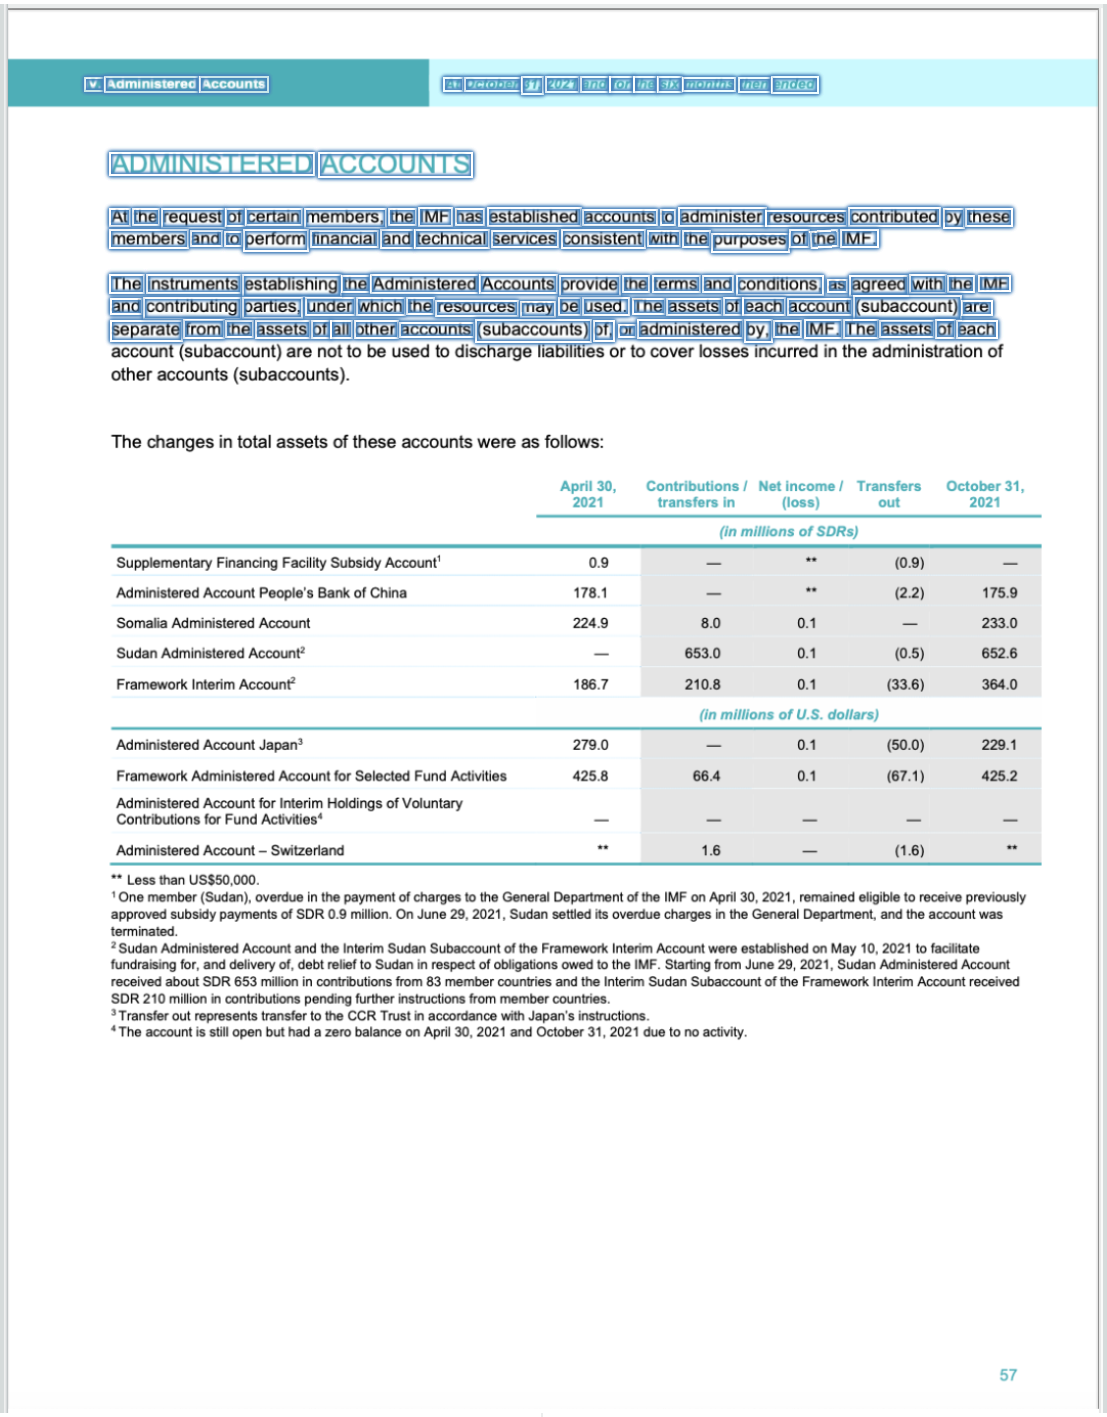
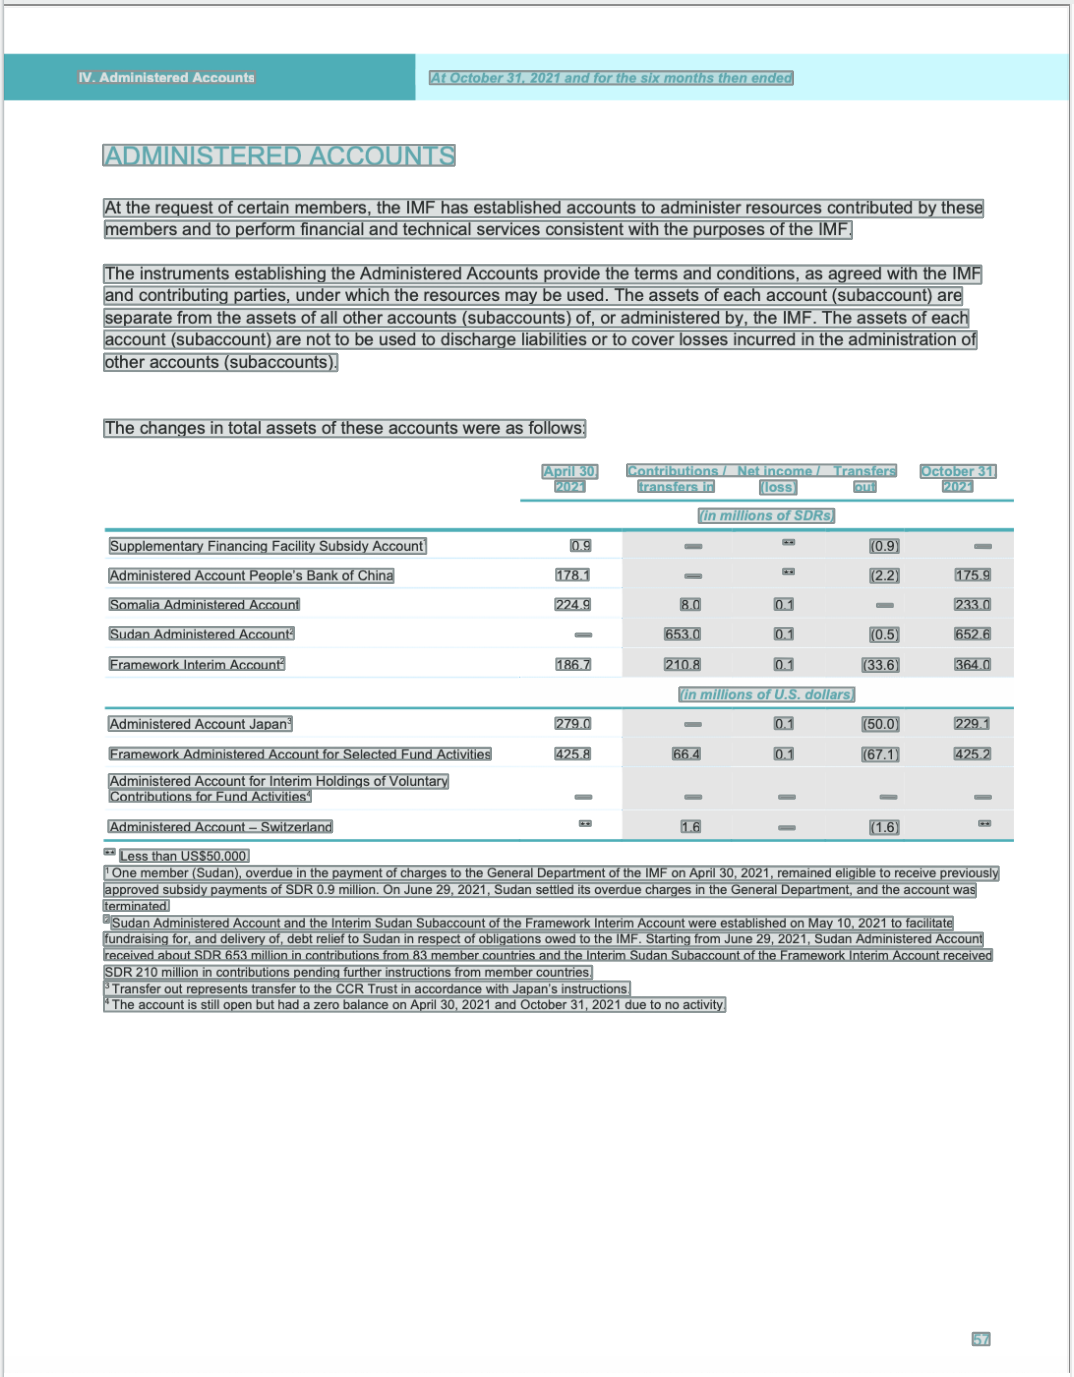
ご覧のとおり、/document/ocr Robot は、ドキュメント内の必要な情報をはるかに的確に認識しています。特に表とその後に続くテキストでは、その差が顕著です。/image/ocr Robot は、この部分の認識にやや苦戦しているようです。
両方の Robot からバウンディングボックスを取得した方法もご紹介します。granularity の値を full にして、認識したテキストのバウンディングボックスを出力に含めました。認識したテキストだけが必要な場合は、この値を list に変更してください。
これだけで、ドキュメントや画像のテキスト認識を始められます。SDK ドキュメントを探し回ったり、API の扱いに苦労したりする必要はありません。とても簡単です。
それでは、また次回!
今回のご紹介はここまでです。ぜひご連絡ください。Robot の魅力的な新しいアイデアをお待ちしています。新たな革新の可能性を常に探しています 💡