
Apresentando a extração de texto de PDFs com Robot de IA

Há algum tempo, oferecemos Robots com IA que vão além das capacidades habituais dos nossos Robots. Por exemplo, muitos leitores talvez já conheçam nosso incansável Robot /image/facedetect, que reconhece automaticamente rostos em uma imagem. Ele é perfeito para identificar um rosto em uma imagem e recortá-lo para a foto de perfil de um usuário.
Hoje, temos o prazer de apresentar uma novidade na nossa família de Robots com IA: o Robot /document/ocr.
Se você tem um olhar atento, talvez tenha percebido que já oferecemos o Robot /image/ocr, que desempenha uma função semelhante, mas claramente diferente entre as nossas ferramentas.
Olhando os detalhes técnicos, o Robot /document/ocr usa AWS Textract e GCP Document AI. Isso significa que ele foi treinado especificamente para lidar com documentos extensos e grandes blocos de texto, como os que você pode encontrar em um romance ou artigo científico. Além disso, ele é excelente na extração de texto de tabelas e formulários, o que também o torna adequado para lidar com faturas, por exemplo.
Em comparação, o Robot /image/ocr usa Amazon Rekognition e Vision API do GCP, ambos treinados com pequenos trechos de texto, como os encontrados em placas de pare, etiquetas de embalagens e crachás.
Talvez a principal diferença, porém, seja que o Robot /document/ocr oferece suporte a PDFs, o que o torna ideal para lidar com documentos importantes dos seus clientes.
Extração de texto
Como sempre, a melhor maneira de você entender essas diferenças é eu mostrá-las a você, em vez de apenas falar sobre elas. Então, vamos analisar a diferença entre os resultados do Robot /document/ocr e os do Robot /image/ocr.
Aqui está o primeiro Template, que usa o Robot /image/ocr.
{
  "steps": {
    ":original": {
      "robot": "/upload/handle"
    },
    "detect": {
      "robot": "/image/ocr",
      "use": ":original",
      "provider": "aws",
      "format": "meta",
      "granularity": "full"
    },
    "exported": {
      "use": "detect",
      "robot": "/s3/store",
      "credentials": "my_s3_credentials"
    }
  }
}
E aqui está o segundo Template, que usa o Robot /document/ocr.
{
  "steps": {
    ":original": {
      "robot": "/upload/handle"
    },
    "detect": {
      "robot": "/document/ocr",
      "use": ":original",
      "provider": "aws",
      "format": "meta",
      "granularity": "full"
    },
    "exported": {
      "use": "detect",
      "robot": "/s3/store",
      "credentials": "my_s3_credentials"
    }
  }
}
As imagens abaixo mostram as caixas delimitadoras de ambos os Templates sobrepostas a uma fatura de exemplo, usando /image/ocr à esquerda e /document/ocr à direita.
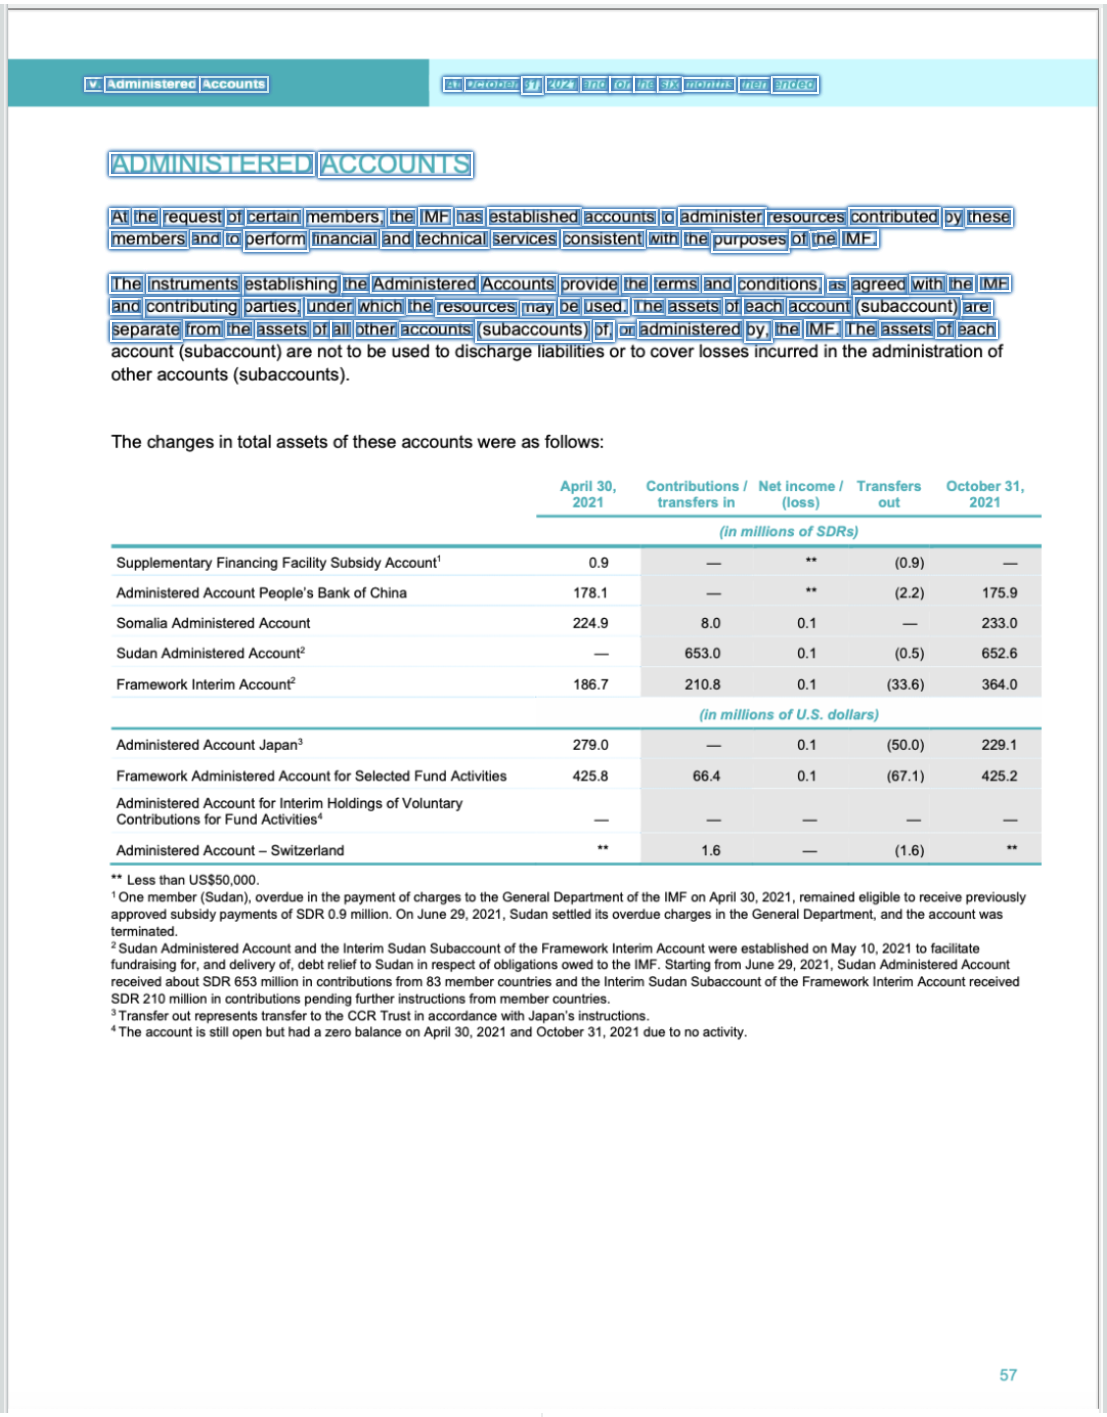
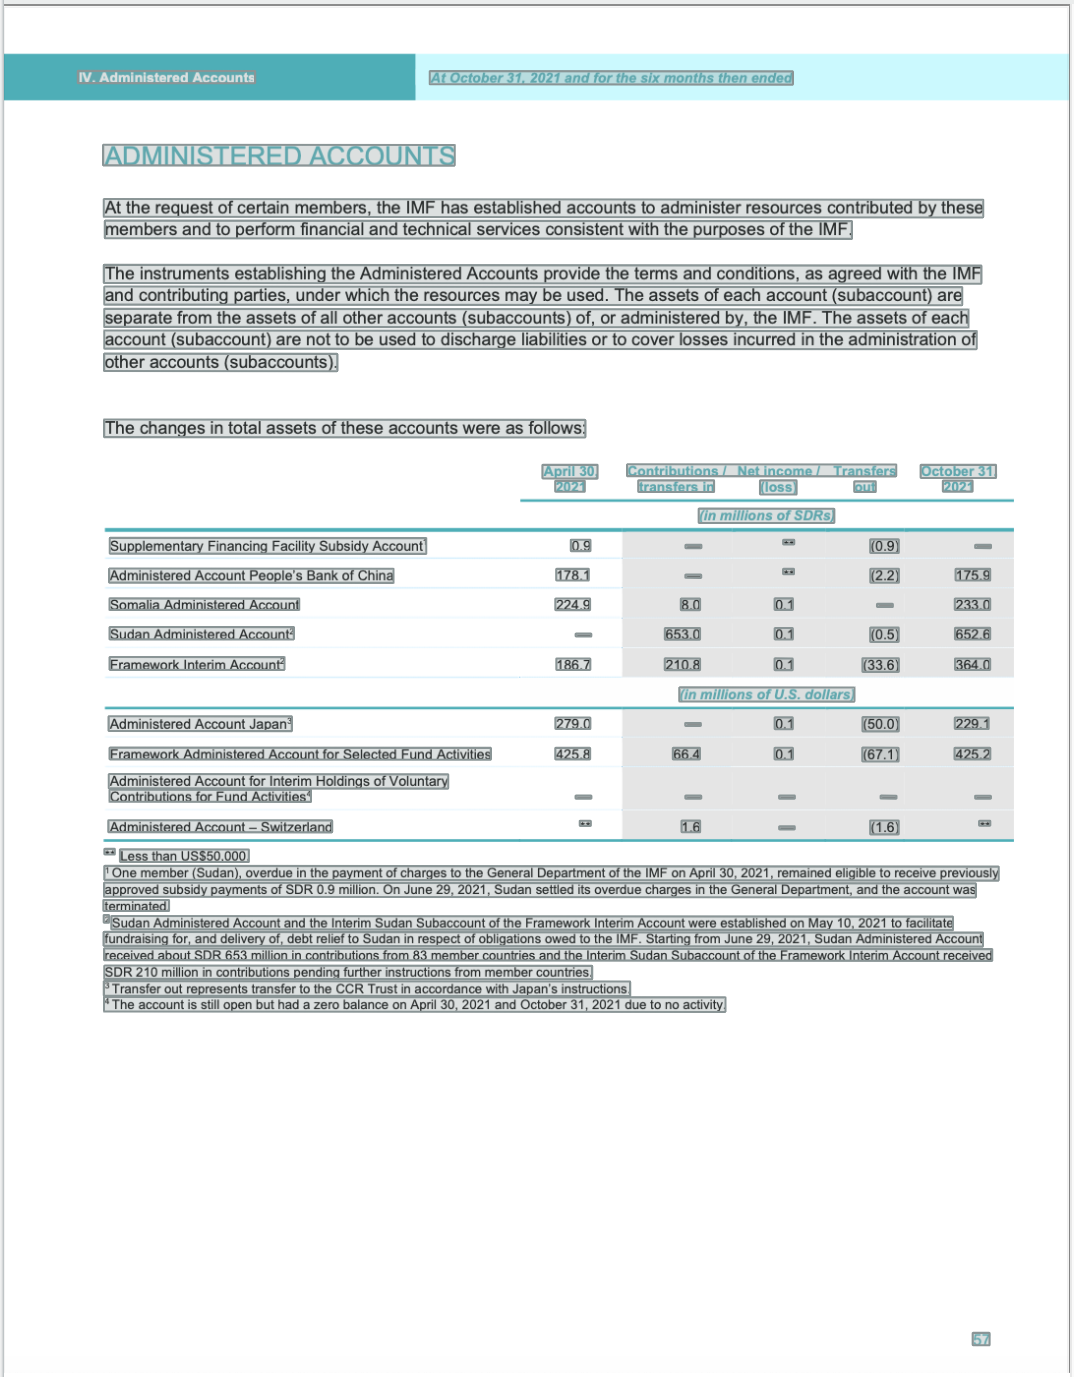
Como demonstrado, o Robot /document/ocr reconhece muito melhor as informações relevantes do documento, especialmente na tabela e no texto que vem depois dela, em que o Robot /image/ocr parece ter um pouco mais de dificuldade.
Se você quer saber como obtivemos as caixas delimitadoras de ambos os
Robots, usamos granularity com o valor
full para incluir as caixas delimitadoras do texto reconhecido nos
resultados. Se você tem interesse apenas no texto reconhecido, altere esse valor para
list.
É só isso que você precisa para começar a reconhecer texto em documentos ou imagens! Não é necessário vasculhar a documentação de SDKs nem se complicar com uma API. É simples assim.
Até a próxima!
Isso é tudo que temos para mostrar por enquanto. Não deixe de entrar em contato conosco se você tiver uma nova ideia interessante para um Robot, pois estamos sempre buscando novas formas de inovar 💡