
Lleva tu biblioteca de Vimeo a tu propio pipeline

Vimeo es un buen lugar para alojar y compartir videos. Pero tarde o temprano muchos equipos quieren que sus videos estén en un entorno que controlen: su propio reproductor, su propia CDN, un repositorio de videos para archivo o un pipeline que añada subtítulos o miniaturas. Extraer los archivos implica escribir un cliente de la API de Vimeo, recorrer las páginas de tu biblioteca, esperar a que terminen de procesarse los videos y elegir la variante adecuada de cada uno.
🤖 /vimeo/import se encarga de la importación, espera durante un tiempo limitado a que termine el procesamiento
y selecciona la variante solicitada antes de enviar los videos al resto de tu Assembly.
Este ejemplo importa una página de hasta 20 videos; page_number tiene el valor predeterminado 1.
Paso 1: dale a Transloadit acceso de lectura a tus videos
Vimeo solo permite que una aplicación descargue tus archivos de video con un token que tenga el permiso Video Files, y concede ese permiso a aplicaciones de terceros únicamente a través de su programa de socios. Por eso debes crear el token en una aplicación de Vimeo propia:
- En developer.vimeo.com/apps, crea una aplicación (o abre una que ya tengas) y genera un token de acceso personal con Public, Private y Video Files.
- En la Transloadit Console, abre Credenciales, añade una credencial de Vimeo, elige
Pegar un token de acceso personal y asígnale un nombre, por ejemplo,
vimeo.
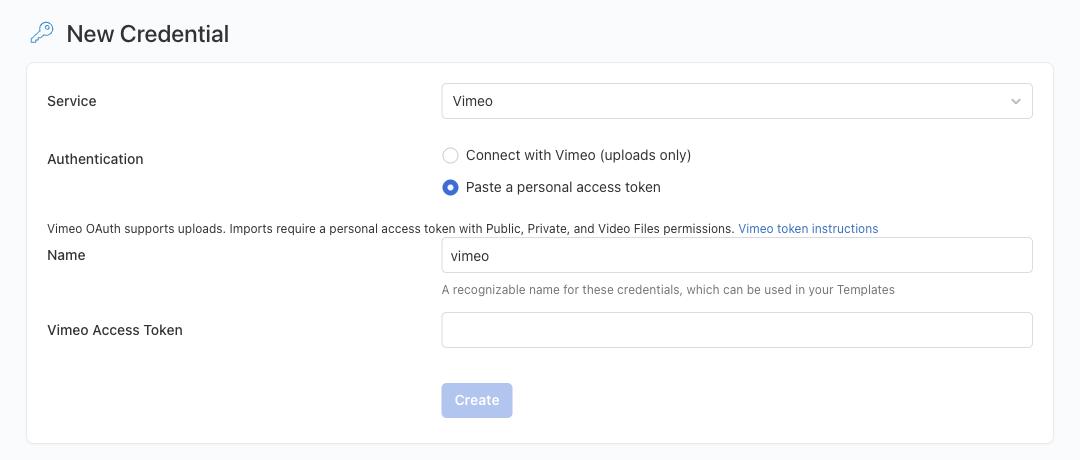
Al guardar, Transloadit verifica el token con Vimeo y te indica si falta algún permiso. El token no vuelve a mostrarse. Las descargas siguen dependiendo de tu plan de Vimeo y de los permisos del video. La documentación de credenciales de Template contiene los detalles.
Paso 2: un solo comando
Primero, autentica la CLI de Transloadit. El
inicio de sesión en el navegador del SDK
usa npx -y @transloadit/node auth login para obtener una clave dedicada a la CLI. Esta autenticación es independiente de la
credencial de Template de Vimeo anterior.
Guarda estas Assembly Instructions como vimeo.json:
{
  "steps": {
    "imported": {
      "robot": "/vimeo/import",
      "credentials": "vimeo",
      "path": "me/videos",
      "rendition": "720p",
      "files_per_page": 20
    },
    "encoded_480p": {
      "use": "imported",
      "robot": "/video/encode",
      "preset": "hls/480p",
      "ffmpeg_stack": "v7"
    },
    "encoded_720p": {
      "use": "imported",
      "robot": "/video/encode",
      "preset": "hls/720p",
      "ffmpeg_stack": "v7"
    },
    "hls": {
      "use": {
        "steps": ["encoded_480p", "encoded_720p"],
        "bundle_steps": true,
        "group_by_original": true
      },
      "robot": "/video/adaptive",
      "technique": "hls",
      "playlist_name": "playlist.m3u8"
    },
    "stored": {
      "use": "hls",
      "robot": "/transloadit/store",
      "path": "vimeo/${file.original_basename}/${file.meta.relative_path}/${file.name}",
      "conflict_strategy": "overwrite",
      "result": true
    }
  }
}
Luego, ejecuta el comando:
npx -y @transloadit/node assemblies create --steps vimeo.json -o out/
Cada video de la página seleccionada se importa a 720p, pasa por encoding a 480p y 720p y se empaqueta
en su propio stream HLS adaptativo. group_by_original mantiene juntas las variantes de cada video, de modo que
obtienes un playlist.m3u8 por video, cuyo nombre corresponde a su ID de Vimeo:
$ find out/hls -name '*.m3u8'
out/hls/1243010274/playlist.m3u8
out/hls/1243010274/852x480_785191_25/852x480_785191_25.m3u8
out/hls/1243010274/1280x720_1367783_25/1280x720_1367783_25.m3u8
out/hls/1243010465/playlist.m3u8
out/hls/1243010465/852x480_769775_25/852x480_769775_25.m3u8
out/hls/1243010465/1280x720_1366589_25/1280x720_1366589_25.m3u8
La misma estructura se guarda de forma privada en tu Transloadit Storage, bajo
vimeo/. La reproducción pública requiere una configuración de entrega independiente; consulta nuestras
preguntas frecuentes sobre alojamiento para obtener una visión general. El ejemplo usa
overwrite de forma intencional: al reejecutarlo, se vuelve a procesar la selección de la página actual
y se crea una nueva versión que se conserva en cada destino que ya exista.
¿Prefieres usar tu propio bucket? Sustituye el último Step por 🤖 /s3/store o por cualquier otro
Robot de almacenamiento con el mismo path.
Adáptalo a tu biblioteca
- Álbumes, canales y más:
pathacepta rutas de la API de Vimeo que enumeran videos, comome/albums/:album_id/videos,me/channels/:channel_id/videosome/likes. - Bibliotecas grandes: Vimeo devuelve hasta 100 videos por página. Configura
files_per_pagey ejecuta el comando una vez porpage_number. La guía de migración de Vimeo a Vimeo explica las limitaciones de la paginación y el seguimiento de la identidad de origen. - Calidad:
renditionacepta desde240phasta1080p, osourcepara el archivo original subido. Los originales solo están disponibles si Vimeo los ha conservado, y no todos los videos tienen todas las variantes. Cuando falta una, la Assembly lo indica en lugar de fallar silenciosamente. - Aún en procesamiento: el tiempo de espera es limitado. Si un video sigue procesándose cuando se alcanza el límite, la importación falla y te pide que vuelvas a intentarlo más tarde. Si falla la transcodificación de Vimeo, la importación falla de inmediato.
Primeros pasos
Crea el token, añade la credencial, autentica la CLI y ejecuta el comando anterior con tu propia cuenta. La documentación de 🤖 /vimeo/import enumera todos los parámetros.